Lecture 14:KMP算法
Chinese-language Computer Science 408 note: Lecture 14:KMP算法. Original source available where applicable.
On this page
This note is currently available in Chinese. The original wording, formulas and diagrams are preserved to avoid an unverified technical translation.
14.1 KMP 算法的基本思想
14.1.1 朴素模式匹配的缺点
问题
- 在朴素模式匹配中,当某次匹配失败时,主串指针
i经常需要回溯。 - 但在不匹配字符之前,主串已经和模式串成功匹配了一部分。
- 这部分已经匹配的信息没有被充分利用,导致时间开销增加。
核心观察
- 不匹配字符之前,一定有一段内容已经和模式串相同。
- 可以利用模式串自身的结构信息,避免主串指针回溯。
14.1.2 KMP 算法
定义:#KMP算法
描述: KMP 算法是一种串的模式匹配算法。它在匹配失败时不回溯主串指针,只调整模式串指针,从而提高匹配效率。
特点
- 主串指针
i不回溯。 - 模式串指针
j根据next数组回退。 - 性能提升来自复用模式串的前后缀结构和已经匹配的信息,避免朴素匹配在失配时让主串整体回退、重复匹配已知前缀;同一主串位置仍可能先后与不同模式串字符比较,并不是“每个主串字符只比较一次”,也不是简单因为模式串通常比主串短。
基本流程
- 预处理:根据模式串
T求出next数组。 - 用指针
i指向主串S。 - 用指针
j指向模式串T。 - 若
S.ch[i] == T.ch[j],则i和j同时后移。 - 若
S.ch[i] != T.ch[j],则i不动,令:
j = next[j];
- 若
j指向模式串末尾之后,说明匹配成功。
NOTE · 教材补充:空模式串 若接口允许模式串长度 $m=0$,通常约定空模式串在主串起始位置匹配成功;返回位置是 $0$ 还是 $1$ 由接口采用的下标体系决定。此时无需构造
next[2]。
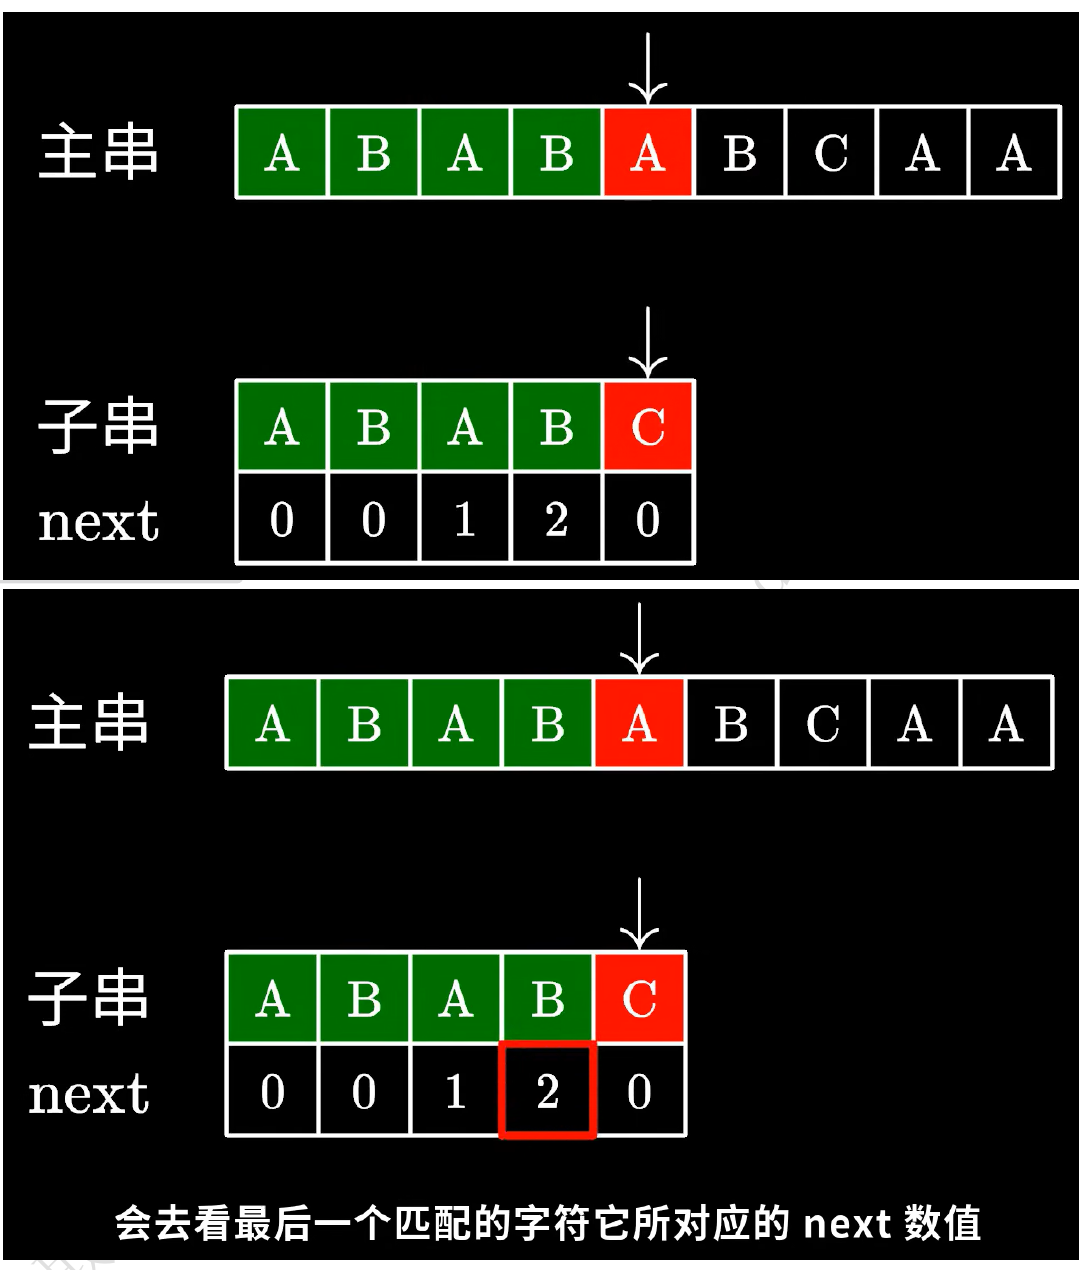
图示解读
- 图中红色字符处失配时,主串指针保持在原位置,模式串指针由
next[j]决定新的比较位置。 - 已经成功匹配的模式串前缀中,能与其后缀重合的部分被直接对齐到主串对应位置,无需从模式串首字符盲目重试。
- 图示使用从 $0$ 起的展示标号,正文算法统一按从 $1$ 起的位序;做题时必须先确认采用哪套
next定义。
14.2 next 数组
14.2.1 next 数组的作用
定义:#next数组
描述: 当模式串第 $j$ 个字符匹配失败时,
next[j]表示模式串指针j应该回退到的位置。
作用
- 修改
j的值。 - 让主串指针
i保持不变。 - 避免朴素算法式的主串回退和已匹配前缀的重复匹配;“主串下标不回退”不等于当前主串位置绝不会再与另一个模式串字符比较。
重要特点
next数组只和模式串有关。next数组和主串无关。- 模式串确定后,
next数组也确定。
14.2.2 PDF 示例:模式串 abaabc
对于模式串:
T = abaabc
PDF 给出的回退规则:
| 匹配失败位置 | 回退后 j |
|---|---|
| 第 1 个字符失败 | 0 |
| 第 2 个字符失败 | 1 |
| 第 3 个字符失败 | 1 |
| 第 4 个字符失败 | 2 |
| 第 5 个字符失败 | 2 |
| 第 6 个字符失败 | 3 |
所以 next 数组为:
| 位置 $j$ | 1 | 2 | 3 | 4 | 5 | 6 |
|---|---|---|---|---|---|---|
| 模式串 | a | b | a | a | b | c |
next[j] |
0 | 1 | 1 | 2 | 2 | 3 |
上表已经逐位保存原图中 abaabc 的模式字符、失败位置和回退值,信息完整且更便于检索,因此不重复嵌图。
14.3 KMP 算法实现
14.3.1 代码
这里沿用上一篇 SString 的最大串长 MAXLEN,因此 next 可用定长数组。原 PDF 的 int next[T.length+1] 是变长数组写法,不能直接当作标准 C++ 数组声明;若模式串改为动态长度,需相应使用动态存储。
void get_next(SString T, int next[]);  // 实现见 14.5

int Index_KMP(SString S, SString T) {
    if (T.length == 0)
        return 1;                  // 本节采用 1 起始位序:空模式在起始位置匹配

    int i = 1, j = 1;
    int next[MAXLEN + 1];

    get_next(T, next);

    while (i <= S.length && j <= T.length) {
        if (j == 0 || S.ch[i] == T.ch[j]) {
            ++i;
            ++j;
        } else {
            j = next[j];
        }
    }

    if (j > T.length)
        return i - T.length;
    else
        return 0;
}
14.3.2 代码解释
初始状态
T.length == 0时直接返回 $1$,与本节“空模式串在主串起始位置匹配”的 1 起始位序约定一致。i = 1:主串从第 $1$ 个字符开始。j = 1:模式串从第 $1$ 个字符开始。next数组提前由模式串求出。
匹配成功
if (j == 0 || S.ch[i] == T.ch[j])
- 若
j == 0,表示模式串已经回退到最前面,需要让主串进入下一个字符重新开始。 - 若当前字符相同,则继续比较后继字符。
匹配失败
j = next[j];
- 主串指针
i不动。 - 模式串指针
j回退到next[j]。
返回值
- 若: $$ j>T.length $$ 说明模式串匹配完成。
- 匹配开始位置为: $$ i-T.length $$
- 若没有匹配成功,返回: $$ 0 $$
14.3.3 算法性能
设:
- 主串长度为 $n$;
- 模式串长度为 $m$。
求 next 数组的时间复杂度:
$$
O(m)
$$
模式匹配过程最坏时间复杂度: $$ O(n) $$
KMP 总时间复杂度: $$ O(n+m) $$
注意
- KMP 主要用于解决主串与模式串的匹配问题。
- 数组传参只需要传数组名,不需要加地址符号。
14.4 求 next 数组
14.4.1 前缀和后缀
定义:#前缀
描述: 本节求
next时使用串的非空真前缀:必须从第一个字符开始、不能为空,也不能等于整个串。
定义:#后缀
描述: 本节求
next时使用串的非空真后缀:必须在最后一个字符结束、不能为空,也不能等于整个串。
例子 对于串:
abab
前缀包括:
a, ab, aba
后缀包括:
b, ab, bab
最长相等非空真前缀与真后缀为:
ab
长度为: $$ 2 $$
14.4.2 next 的本质
求 next 数组的本质:
- 对于模式串第 $j$ 个字符;
- 看它前面 $1\sim j-1$ 个字符组成的子串;
- 找这个子串的最长相等非空真前缀与真后缀;
next[j]等于该最长相等真前后缀的长度加 $1$;若不存在,则把长度视为 $0$。
公式: $$ next[j]=\text{最长相等非空真前缀与真后缀长度}+1 $$
特别地: $$ next[1]=0 $$
固定规则
- 对任意非空模式串,第 $1$ 个字符不匹配时,只能匹配下一个子串: $$ next[1]=0 $$
- 当模式串长度至少为 $2$ 时,第 $2$ 个字符不匹配后应尝试匹配模式串第 $1$ 个字符: $$ next[2]=1 $$
14.4.3 手算方法
题型:#求next数组
第一部分:解题方法
- 在不匹配的位置前边,划一根分界线。
- 只看分界线前面的模式串片段。
- 找该片段的最长相等非空真前缀与真后缀。
- 其长度加 $1$,就是
next[j]。 - 若没有相等前后缀,则
next[j]=1。 - 特别地,
next[1]=0。
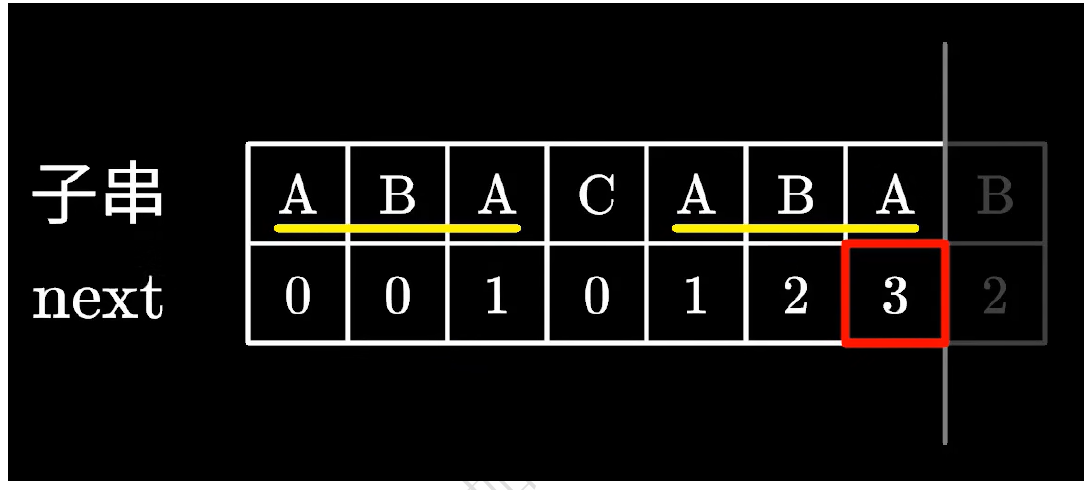
图示解读
- 分界线位于当前失配位置之前,求
next[j]时只研究前 $j-1$ 个模式字符。 - 黄色下划线标出相等的非空真前缀和真后缀;它们的最大长度决定能保留多少已经匹配的信息。
- 本节采用 $1$ 起始位序,所以
next[j]是最长相等真前后缀长度加 $1$,而不是长度本身。
第二部分:典型例题
例题:求模式串 abaabc 的 next 数组
| 位置 $j$ | 分界线前的子串 | 最长相等非空真前后缀 | 长度 | next[j] |
|---|---|---|---|---|
| 1 | 空 | 特殊规定 | - | 0 |
| 2 | a |
无 | 0 | 1 |
| 3 | ab |
无 | 0 | 1 |
| 4 | aba |
a |
1 | 2 |
| 5 | abaa |
a |
1 | 2 |
| 6 | abaab |
ab |
2 | 3 |
所以:
next = [0, 1, 1, 2, 2, 3]
第三部分:知识点复盘
next[j]关注的是第 $j$ 个字符匹配失败时该跳到哪里。- 计算
next[j]时,只看前 $j-1$ 个字符。 next数组只和模式串有关。
14.5 get_next 代码
14.5.1 代码实现
void get_next(SString T, int next[]) {
    int i = 1, j = 0;
    next[1] = 0;

    while (i < T.length) {
        if (j == 0 || T.ch[i] == T.ch[j]) {
            ++i;
            ++j;
            next[i] = j;
        } else {
            j = next[j];
        }
    }
}
14.5.2 代码理解
i表示当前要求next的位置。j表示当前最长相等非空真前后缀的下一位置。- 若
j == 0,说明已经无法继续回退。 - 若
T.ch[i] == T.ch[j],说明前后缀可以继续扩展。 - 若不相等,则:
j = next[j];
继续回退,直到找到可扩展位置或退到 $0$。
14.6 KMP 优化:nextval 数组
14.6.1 优化动机
定义:#nextval数组
描述:
nextval是对next数组的优化,用于避免模式串回退后再次比较同一个必然失败的字符。
问题
- 有时
next[j]指向的位置字符与当前失败字符相同。 - 这意味着回退后还会再次失败。
- 因此可以继续沿着
next回退,得到更优位置。
优化思路
- 判断
next[j]所指向的字符和当前字符是否相等。 - 如果不相等,则保留原来的
next[j]。 - 如果相等,则用
nextval[next[j]]继续优化。
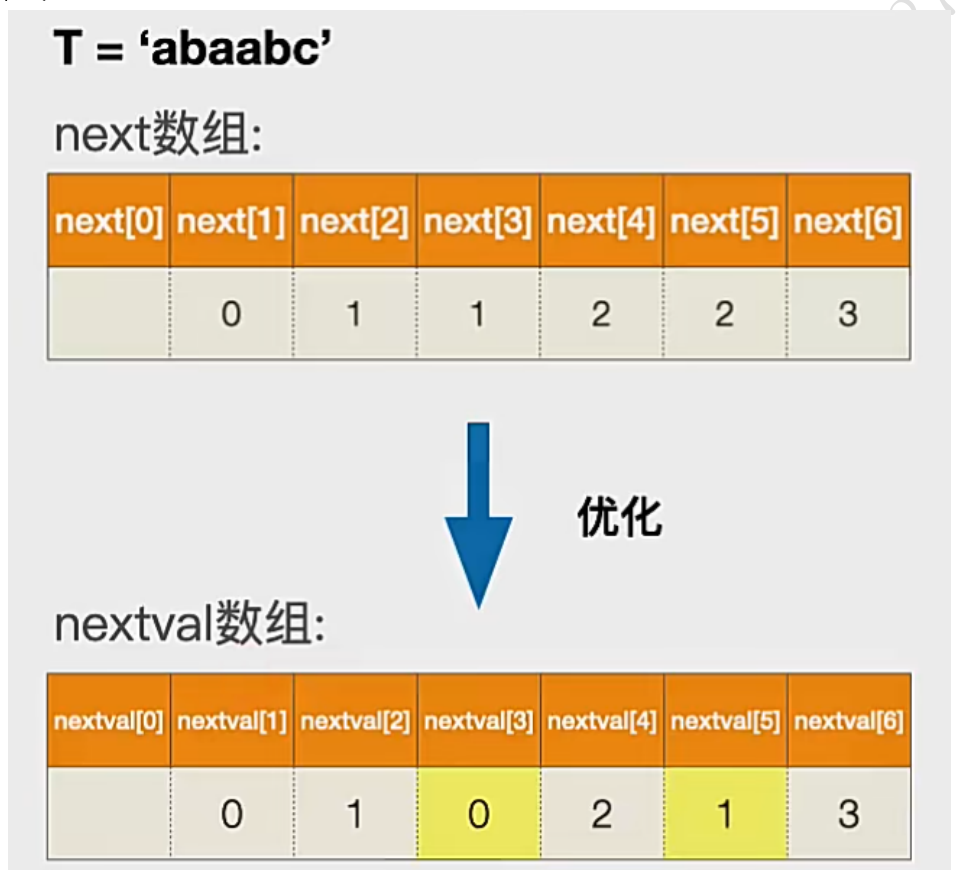
图示解读
- 当失配字符
T.ch[j]与T.ch[next[j]]相同,直接回退到next[j]仍会比较同一字符并再次失败。 nextval[j]继续沿失败函数跳过这些必败位置;若两字符不同,则保留原next[j]。nextval只优化失败后的跳转,不改变匹配结果,也不依赖主串。
14.6.2 求 nextval 的方法
方法
- 先求
next数组。 - 再由
next数组求nextval数组。
规则
nextval[1]直接写: $$ 0 $$- 从第 $2$ 个位置开始:
- 若
T.ch[next[j]] == T.ch[j],则:
- 若
nextval[j] = nextval[next[j]];
+ 否则:
nextval[j] = next[j];
14.6.3 代码实现
nextval[1] = 0;

for (int j = 2; j <= T.length; j++) {
    if (T.ch[next[j]] == T.ch[j])
        nextval[j] = nextval[next[j]];
    else
        nextval[j] = next[j];
}
14.6.4 PDF 示例
对于模式串:
ababaa
PDF 图示给出的数组为:
| 位置 $j$ | 1 | 2 | 3 | 4 | 5 | 6 |
|---|---|---|---|---|---|---|
| 模式串 | a | b | a | b | a | a |
next[j] |
0 | 1 | 1 | 2 | 3 | 4 |
nextval[j] |
0 | 1 | 0 | 1 | 0 | 4 |
解释
- 第 $3$ 个字符
a与next[3]=1指向的字符a相同,所以优化为nextval[1]=0。 - 第 $4$ 个字符
b与next[4]=2指向的字符b相同,所以优化为nextval[2]=1。 - 第 $5$ 个字符
a与next[5]=3指向的字符a相同,所以优化为nextval[3]=0。 - 第 $6$ 个字符
a与next[6]=4指向的字符b不同,所以保留next[6]=4。
原 PDF 第 9 页还给出重复字符较多的模式串 aaaab:
| 位置 $j$ | 1 | 2 | 3 | 4 | 5 |
|---|---|---|---|---|---|
| 模式串 | a | a | a | a | b |
next[j] |
0 | 1 | 2 | 3 | 4 |
nextval[j] |
0 | 0 | 0 | 0 | 4 |
前四个位置的 a 失配后,回退到另一个 a 仍会失败,故 nextval 连续跳过这些位置;第 $5$ 位的 b 与 next[5]=4 指向的 a 不同,保留回退位置 $4$。这说明 nextval 的优化收益依赖模式串的重复结构。
14.7 题型整理
题型:#KMP匹配过程
第一部分:解题方法
- 主串指针
i不回退。 - 模式串指针
j根据next[j]回退。 - 若
j == 0,则i++、j++,开始匹配下一个主串位置。 - 若字符相同,则
i++、j++。 - 若字符不同,则
j = next[j]。
第二部分:典型例题
例题:KMP 为什么比朴素匹配快?
答:
- 朴素匹配失败后,主串指针可能回退。
- KMP 利用模式串的
next数组,让主串指针不回退。 - 已匹配成功的主串前缀不随主串指针回退而整段重比;当前失配位置仍可能与回退后的另一个模式串字符继续比较。
- 因此匹配过程最坏时间复杂度降为: $$ O(n) $$
第三部分:知识点复盘
- KMP 的核心不是换了比较方式,而是换了失败后的回退方式。
- 主串不回退,模式串回退。
- 回退依据是
next或nextval数组。
题型:#nextval优化
第一部分:解题方法
- 先求
next数组。 - 再逐位判断
T.ch[next[j]]和T.ch[j]是否相等。 - 相等时用
nextval[next[j]]。 - 不相等时用
next[j]。
第二部分:典型例题
例题:为什么 nextval 可以减少比较?
答:
- 如果回退后指向的字符和当前失败字符相同,那么再次比较仍然会失败。
nextval直接跳过这种必然失败的位置。- 所以可以减少重复比较。
第三部分:知识点复盘
nextval是next的优化。nextval不是重新定义模式匹配,而是优化失败后的跳转位置。
相关知识
14.8 本节复盘
必须掌握
- KMP 中主串指针
i不回溯。 - 模式串指针
j根据next[j]回退。 next数组只和模式串有关。- 对非空模式串,
next[1]=0;当模式串长度至少为 $2$ 时,next[2]=1。 next[j]等于前 $j-1$ 个字符组成子串的最长相等非空真前缀与真后缀长度加 $1$;不存在时长度按 $0$ 计。- KMP 总时间复杂度: $$ O(n+m) $$
nextval用来避免回退后再次比较必然失败的字符。
易错点
- 不要让主串指针
i回退。 - 求
next[j]时看的是第 $j$ 个字符之前的子串。 - 这里使用非空真前缀和非空真后缀,二者都不能等于整个串。
next和nextval都是针对模式串,不是针对主串。- 不同教材有不同下标体系,本节按 PDF 的 1 起始位序写法。
一句话总结
- KMP 的关键是用模式串自身的前后缀信息构造
next数组,匹配失败时只回退模式串指针,从而避免主串回溯。