Lecture 13:串
Chinese-language Computer Science 408 note: Lecture 13:串. Original source available where applicable.
On this page
This note is currently available in Chinese. The original wording, formulas and diagrams are preserved to avoid an unverified technical translation.
13.1 串的基本概念
定义:#串
描述: 串,即字符串,是由零个或多个字符组成的有限序列。
一般记为: $$ S=a_1a_2\cdots a_n $$
其中:
- $S$ 是串名。
- $S$ 的整体表示串的值。
- $a_i$ 可以是字母、数字或其他字符。
- 串中字符的个数称为串的长度。
当:
$$
n=0
$$
时,该串称为空串,通常用 "" 或:
$$
\varepsilon
$$
表示。
空串是长度为 $0$ 的串,不是空集 $\emptyset$;串是字符序列,集合是另一类数学对象。
例子
S = "HelloWorld"
注意
- 有些语言用双引号表示字符串,如 Java、C。
- 有些语言也可以用单引号表示字符串,如 Python。
- 空格也是一种字符。
13.2 串的相关概念
13.2.1 子串和主串
定义:#子串
描述: 子串是串中任意个连续字符组成的子序列。
定义:#主串
描述: 主串是包含某个子串的串。
例子
S = "iPhone 11 Pro Max?"
T = "Pro"
T是S的子串。S是T的主串。
13.2.2 位置
字符在主串中的位置
- 字符在串中的序号。
- 同一字符可以在串中出现多次,每次出现都有各自的位序;只有“查找字符第一次出现位置”这类操作才特指第一次出现。
子串在主串中的位置
- 子串第一个字符在主串中的位置。
重要注意
- 串的位序通常从 $1$ 开始,而不是从 $0$ 开始。
- 这和 C 语言数组下标从 $0$ 开始不同。
13.3 串的结构特点
串是一种特殊的线性表
- 数据元素之间呈线性关系。
- 每个数据元素都是字符。
串与普通线性表的区别
- 串的数据对象限定为字符集。
- 中文字符;
- 英文字符;
- 数字字符;
- 标点字符;
- 空格字符。
- 串的基本操作通常以子串为操作对象。
- 例如增删改查常常不是操作单个字符,而是操作一段子串。
13.4 串的基本操作
设:
T = ""
S = "iPhone 11 Pro Max?"
W = "Pro"
13.4.1 基本操作表
| 操作 | 含义 |
|---|---|
StrAssign(&T, chars) |
赋值操作,把串 T 赋值为 chars |
StrCopy(&T, S) |
复制操作,由串 S 复制得到串 T |
StrEmpty(S) |
判空操作,若 S 为空串则返回 TRUE,否则返回 FALSE |
StrLength(S) |
求串长,返回串 S 的元素个数 |
ClearString(&S) |
清空操作,将 S 清为空串 |
DestroyString(&S) |
销毁串,回收串 S 的存储空间 |
Concat(&T, S1, S2) |
串联接,用 T 返回由 S1 和 S2 联接成的新串 |
SubString(&Sub, S, pos, len) |
求子串,用 Sub 返回从 S 第 pos 个字符起长度为 len 的子串 |
Index(S, T) |
定位操作,返回 T 在主串 S 中第一次出现的位置,不存在则返回 0 |
StrCompare(S, T) |
比较操作,比较两个串的大小 |
13.4.2 串比较规则
规则
- 从第一个字符开始往后依次比较。
- 先出现更大字符的串更大。
- 若扫描过的所有字符都相同,则长度更长的串更大。
- 只有两个串完全相同时才相等。
例子
"ab" < "ac"
原因是:
'b' < 'c'
返回值
- 若 $S>T$,则返回值 $>0$。
- 若 $S=T$,则返回值 $=0$。
- 若 $S<T$,则返回值 $<0$。
13.4.3 字符集
ASCII 字符集
- 常用于英文字符。
- 考研中通常默认每个字符占 $1B$。
Unicode 字符集
- 可表示中英文等更多字符。
- 基于同一个字符集可以有多种编码方案。
- 例如:
- UTF-8;
- UTF-16。
注意
- 不同编码方式下,每个字符所占空间可能不同。
- 考研题中若无特别说明,通常默认每个字符占: $$ 1B $$
ASCII 常用范围
| 十进制编码 | 内容 |
|---|---|
| $0\sim31$、$127$ | 控制字符 |
| $32$ | 空格 |
| $48\sim57$ | 数字 0 至 9 |
| $65\sim90$ | 大写字母 A 至 Z |
| $97\sim122$ | 小写字母 a 至 z |
标准 ASCII 是 $7$ 位编码,范围为 $0\sim127$;所谓“扩展 ASCII”不是唯一统一标准。原图信息已由本表完整结构化。
13.5 串的顺序存储
13.5.1 静态数组实现
定义:#串的顺序存储
描述: 串的顺序存储用一组地址连续的存储单元保存串中的字符。
基本概念
- 每个
char字符占 $1B$。 - 通常还需要额外位置保存当前串的实际长度。
四种方案
| 方案 | 做法 | 说明 |
|---|---|---|
| 方案一 | 把 length 放到数组最后 |
字符区在前,长度在后 |
| 方案二 | 用 ch[0] 充当 length |
字符位序和数组下标一致 |
| 方案三 | 不单独存长度,以 \0 结尾 |
类似 C 风格字符串,求长度需扫描 |
| 方案四 | ch[0] 空置,字符从 ch[1] 开始,长度另存于独立变量 |
教材与本节代码采用的方案 |
方案二缺点
- 若用一个字符单元
ch[0]保存长度,串长会受该单元可表示范围限制;按 $8$ 位无符号值理解时最多表示 $255$。 - C/C++ 中普通
char是否有符号由实现决定,若真正存长度应明确使用unsigned char或更宽的整数类型。
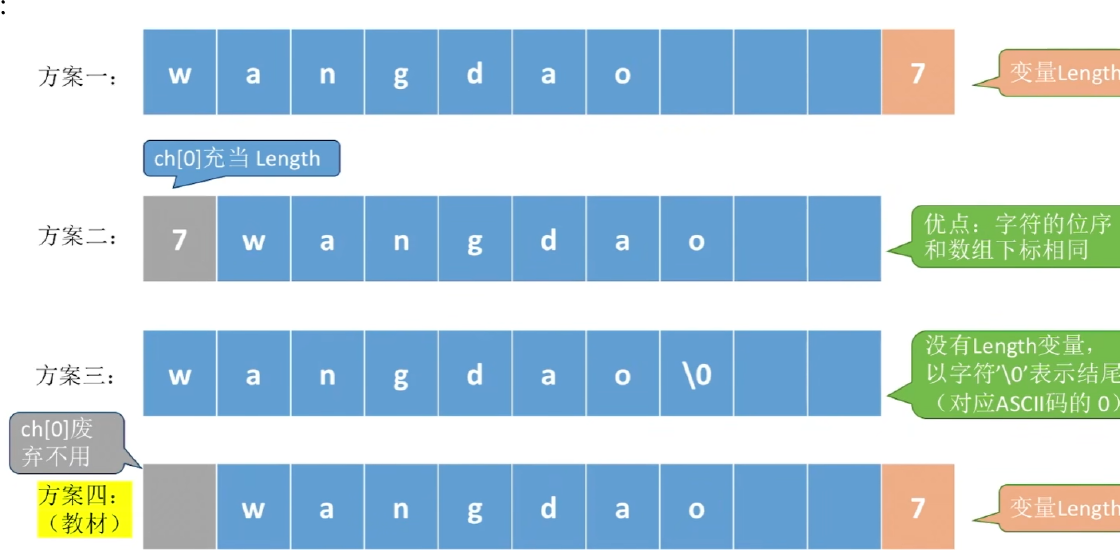
图示解读
- 方案二和方案四都让字符位序与数组下标一致,但方案二把长度塞进
ch[0],方案四则让ch[0]空置并用独立整数字段保存长度。 - 方案三依靠终止符判断结尾,串内不能把
\0当普通字符使用;方案一、二、四可在 $O(1)$ 时间取得已保存的长度。
代码定义:静态数组实现
#define MAXLEN 255

typedef struct {
    char ch[MAXLEN + 1];  // ch[0] 空置,字符使用 ch[1]...ch[MAXLEN]
    int length;
} SString;
说明
ch中每个分量存储一个字符。length表示串的实际长度。- 静态数组作为局部变量时,空间可由系统自动回收。
13.5.2 动态存储
代码定义
typedef struct {
    char *ch;
    int length;
} HString;
申请空间
S.ch = (char *)malloc((MAXLEN + 1) * sizeof(char));
S.length = 0;
说明
ch指向串的基地址。- 此例继续采用字符位序从 $1$ 开始、
ch[0]空置的约定,因此要为最多MAXLEN个字符申请MAXLEN+1个单元;若改用从 $0$ 开始的存储约定,应同步改动所有访问下标。 - 这里仅表示运行时申请空间,不会自动扩容;要容纳更长的串,必须重新分配并维护实际容量。
- 动态申请的空间需要手动释放:
free(S.ch);
13.6 串的链式存储
13.6.1 一般存储方法
代码
typedef struct StringNode {
    char ch;
    struct StringNode *next;
} StringNode, *String;
特点
- 每个结点存储 $1$ 个字符。
- 指针域会带来较大额外开销。
- 每个字符通常占 $1B$;指针在 $32$ 位环境中通常占 $4B$,在 $64$ 位环境中通常占 $8B$,还可能因内存对齐产生额外填充,因此单字符结点的存储密度很低。
13.6.2 改进存储方法
思想
- 每个结点存储多个字符。
- 若最后一个结点有空位,可用特殊字符填充。
- 这样可以提高存储密度。
代码
typedef struct StringNode {
    char ch[4];
    struct StringNode *next;
} StringNode, *String;
说明
- PDF 中以每个结点存 $4$ 个字符为例。
- 真实实现中,每个结点存多少字符取决于设计。
13.7 串的基本操作代码
13.7.1 求子串 SubString
功能
- 传入空的
Sub。 - 用
Sub返回从S的第pos个字符开始、长度为len的子串。
越界条件
必须同时满足:
$$
pos\ge 1,\qquad len\ge 0,\qquad pos+len-1\le S.length
$$
否则参数非法或子串越界。长度为 $0$ 时允许取得空串,但起点不能超过 S.length+1。
代码
bool SubString(SString &Sub, SString S, int pos, int len) {
    if (pos < 1 || len < 0 || pos + len - 1 > S.length)
        return false;

    for (int i = pos; i < pos + len; i++)
        Sub.ch[i - pos + 1] = S.ch[i];

    Sub.length = len;
    return true;
}
解释
- 串的位序从 $1$ 开始。
Sub.ch[1]保存子串第一个字符。Sub.ch[i - pos + 1]用于把主串位置映射到子串位置。
13.7.2 比较操作 StrCompare
返回值
- $S>T$,返回值 $>0$。
- $S=T$,返回值 $=0$。
- $S<T$,返回值 $<0$。
代码
int StrCompare(SString S, SString T) {
    for (int i = 1; i <= S.length && i <= T.length; i++) {
        if (S.ch[i] != T.ch[i])
            return (unsigned char)S.ch[i] - (unsigned char)T.ch[i];
    }

    return S.length - T.length;
}
解释
- 如果某一位字符不同,在本节单字节编码模型下返回无符号字节值之差,避免
char默认有符号时的比较歧义。 - 如果扫描过的所有字符都相同,则长度长的串更大。
- 该代码比较的是存储字节,不是中文等多字节文本的自然语言排序;处理 Unicode 字符和本地化排序时须另定字符边界与比较规则。
13.7.3 定位操作 Index
定义:#Index
描述: 若主串
S中存在与串T值相同的子串,则返回它在主串S中第一次出现的位置;否则返回0。
代码:借助 SubString 和 StrCompare
以下实现与后文逐字符扫描的 Index 是两种备选写法,不能把两个同名函数原样放进同一程序。
int Index(SString S, SString T) {
    int i = 1;
    int n = StrLength(S);
    int m = StrLength(T);
    SString sub;

    while (i <= n - m + 1) {
        SubString(sub, S, i, m);

        if (StrCompare(sub, T) != 0)
            ++i;
        else
            return i;
    }

    return 0;
}
解释
- 当 $1\le m\le n$ 时,最多需要比较: $$ n-m+1 $$ 个子串;$m>n$ 时没有候选,$m=0$ 时按空模式约定直接在起始位置成功。
- 每次取出从位置 $i$ 开始、长度为 $m$ 的子串。
- 若子串和模式串相等,则返回 $i$。
- 若全部不相等,则返回 $0$。
13.8 串的朴素模式匹配算法
13.8.1 串的模式匹配
定义:#模式匹配
描述: 串的模式匹配是在主串中找到与模式串相同的子串,并返回其所在位置。
模式串
- 想在主串中找到的目标串。
- 模式串不一定能在主串中找到。
定位操作
- 定位操作也称模式匹配。
Index(S, T):- 若主串
S中存在与T值相同的子串,返回第一次出现的位置; - 否则返回 $0$。
- 若主串
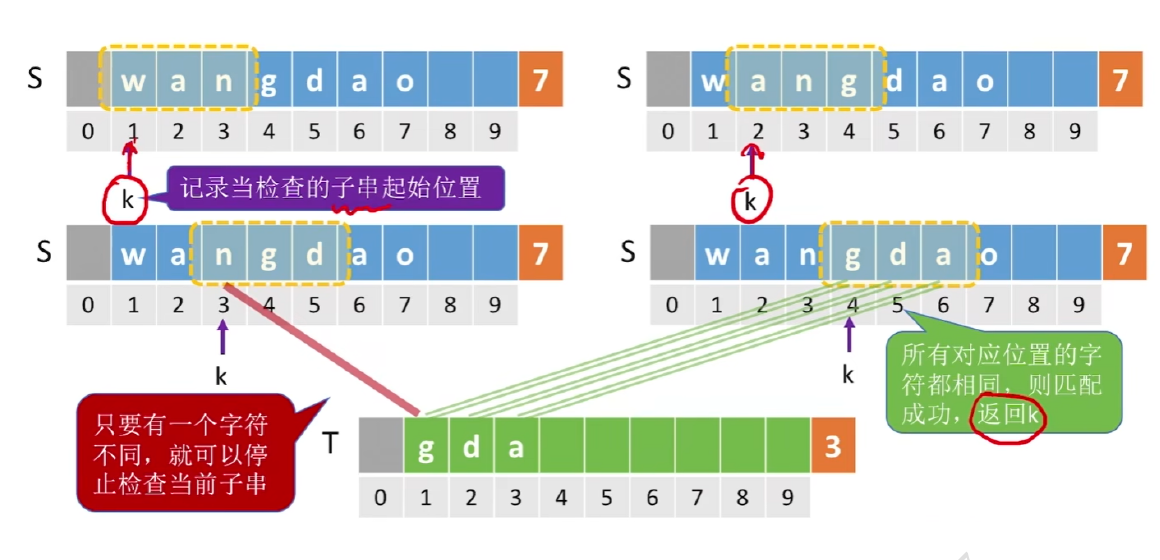
图示解读
- 每轮固定一个候选起点
k,从该位置起逐字符比较主串和模式串。 - 只要出现一个不相等字符,本轮立即失败,候选起点后移一位,模式串重新从第一个字符比较。
- 所有对应字符都相等时返回当前起点;因此朴素算法会重复比较已经比较过的主串字符。
13.8.2 朴素模式匹配过程
过程
- 取出从位置 $i$ 开始、长度为 $m$ 的子串。
- 将该子串和模式串逐字符比较。
- 若匹配成功,则返回当前起始位置。
- 若不匹配,则匹配下一个子串。
- 匹配下一子串时:
- 主串指针
i指向下一个子串的第一个位置; - 模式串指针
j回到模式串的第一个位置。
- 主串指针
最多比较的子串数 设主串长度为 $n$,模式串长度为 $m$。
当 $1\le m\le n$ 时,最多对比: $$ n-m+1 $$ 个候选子串。若 $m>n$,不存在长度为 $m$ 的候选子串,可直接判定匹配失败;若 $m=0$,通常约定空模式串在起始位置匹配成功,不能机械套用 $n-m+1$ 作为字符比较次数。
13.8.3 代码实现
int Index(SString S, SString T) {
    if (T.length == 0)
        return 1;                  // 本节采用 1 起始位序
    if (T.length > S.length)
        return 0;

    int k = 1;
    int i = k;
    int j = 1;

    while (i <= S.length && j <= T.length) {
        if (S.ch[i] == T.ch[j]) {
            ++i;
            ++j;
        } else {
            k++;
            i = k;
            j = 1;
        }
    }

    if (j > T.length)
        return k;
    else
        return 0;
}
变量含义
| 变量 | 含义 |
|---|---|
k |
当前正在尝试匹配的子串起始位置 |
i |
主串当前比较位置 |
j |
模式串当前比较位置 |
匹配成功条件 若: $$ j>T.length $$ 说明模式串已经全部匹配成功。
匹配失败时
k++:检查下一个子串。i = k:主串指针回到新子串起点。j = 1:模式串指针回到第一个字符。
13.8.4 时间复杂度
设:
- 主串长度为 $n$;
- 模式串长度为 $m$。
在 $1\le m\le n$ 的前提下,最坏情况下:
- 共有 $n-m+1$ 个子串需要尝试。
- 每个子串最多比较 $m$ 个字符。
所以: $$ O((n-m+1)m)=O(nm) $$
若 $m>n$,先比较长度即可在 $O(1)$ 时间判定失败;若 $m=0$,按上述空模式约定在 $O(1)$ 时间返回起始位置。
13.9 题型整理
题型:#串的基本概念
第一部分:解题方法
- 判断是否为子串时,必须连续。
- 判断子串位置时,取子串第一个字符在主串中的位置。
- 串的位序从 $1$ 开始,别和数组下标混淆。
第二部分:典型例题
例题:"Pro" 在 "iPhone 11 Pro Max?" 中的位置是多少?
按本节从 $1$ 开始的位序,空格也计入长度:iPhone 占第 $1$–$6$ 位、空格第 $7$ 位、11 为第 $8$–$9$ 位、第二个空格第 $10$ 位,因此 "Pro" 的 P 在第 $11$ 位,Index(S,T)=11。主串第 $2$ 位虽也是 P,但其后不是 ro,不能只按单个字符查找。
第三部分:知识点复盘
- 子串必须连续。
- 主串包含子串。
- 空格也是字符。
- 空串长度为 $0$。
题型:#朴素模式匹配
第一部分:解题方法
- 从主串第 $1$ 个位置开始尝试。
- 逐个字符和模式串比较。
- 一旦失败,就回到下一个起始位置重新比较。
- 模式串匹配完,返回当前起始位置。
- 主串所有可能起点都失败,返回 $0$。
第二部分:典型例题
例题:为什么朴素模式匹配最坏时间复杂度是 $O(nm)$?
在 $1\le m\le n$ 的前提下:
- 最多尝试 $n-m+1$ 个起始位置;
- 每个起始位置最多比较 $m$ 个字符。
所以: $$ O((n-m+1)m)=O(nm) $$
$m>n$ 与 $m=0$ 分别按“长度不足立即失败”和“空模式在起点成功”的边界处理,均不套用上述逐字符最坏过程。
第三部分:知识点复盘
- 朴素模式匹配失败后,模式串指针回到 $1$。
- 主串起始位置后移 $1$。
- KMP 算法的改进点就在于避免不必要的回退。
相关知识
- 科目导航:数据结构导航
- 阅读顺序:上一篇:特殊矩阵与压缩存储 · 下一篇:KMP 算法
- 关联专题:重点算法汇总
13.10 本节复盘
必须掌握
- 串是由零个或多个字符组成的有限序列。
- 空串长度为 $0$。
- 子串必须是连续字符序列。
- 串的位序通常从 $1$ 开始。
- 串是一种特殊线性表,数据对象限定为字符集。
- 串的操作通常以子串为对象。
- 顺序存储可以静态数组实现,也可以动态分配。
- 链式存储可以一个结点存一个字符,也可以一个结点存多个字符。
Index(S, T)是定位操作,也称模式匹配。- 朴素模式匹配最坏时间复杂度为: $$ O(nm) $$
易错点
- 子串不是子序列,子串必须连续。
- 空格也是字符。
- 字符串位序从 $1$ 开始,而 C 数组下标从 $0$ 开始。
Index查找失败返回 $0$。StrCompare不是只看长度,而是先逐字符比较。- 朴素模式匹配失败后,
j回到 $1$,k后移一位。
一句话总结
- 串是操作对象受限为字符的特殊线性表,常考基本概念、存储结构、子串定位和朴素模式匹配复杂度。