Lecture 25:顺序查找和折半查找
Chinese-language Computer Science 408 note: Lecture 25:顺序查找和折半查找. Original source available where applicable.
On this page
This note is currently available in Chinese. The original wording, formulas and diagrams are preserved to avoid an unverified technical translation.
三种方法都基于线性表,但使用前提不同:顺序查找几乎没有前提;折半查找要求有序顺序表;分块查找要求块间有序、块内可无序。做题时先判断数据是否有序、是否能随机访问,再选算法。
25.1 顺序查找
25.1.1 基本思想与普通实现
定义:#顺序查找 #线性查找
描述:从表的一端开始,依次将待查关键字与表中元素的关键字比较,直到找到相等元素或扫描完表。顺序查找适用于顺序表和链表,也不要求表有序。
typedef struct {
    ElemType *elem;
    int TableLen;
} SSTable;

int Search_Seq(SSTable ST, ElemType key) {
    for (int i = 0; i < ST.TableLen; ++i)
        if (ST.elem[i] == key)
            return i;
    return -1;
}
复杂度:
- 最好情况:第一个元素即为目标,比较 $1$ 次。
- 最坏情况:目标在最后,或目标不存在,比较 $n$ 次。
- 时间复杂度为 $O(n)$;额外空间复杂度为 $O(1)$。
- 等概率成功查找时,第 $i$ 个被比较到的元素查找长度为 $i$:
$$ ASL_{\text{成功}}=\frac{1+2+\cdots+n}{n}=\frac{n+1}{2} $$
25.1.2 哨兵优化
定义:#哨兵
描述:在顺序表的约定位置暂存待查关键字,使循环只需判断“当前元素是否等于关键字”,省去每轮边界判断。
// 约定 elem[1..TableLen] 存真实记录,elem[0] 是保留的哨兵位
int Search_Seq_Sentinel(SSTable ST, ElemType key) {
    ST.elem[0] = key;
    int i = ST.TableLen;
    while (ST.elem[i] != key)
        --i;
    return i;  // i==0 表示失败;否则为真实记录位置
}
- 哨兵只减少循环中的控制判断,不改变顺序查找的渐进复杂度。
- 必须确认数组预留了下标 $0$;若所有位置都存真实数据,直接写
elem[0]会破坏记录。 - 失败时会最终与哨兵比较,统计查找长度时要按题目对“关键字比较”的约定计算,不能把优化后的代码与普通实现的比较次数混写。
25.1.3 有序表与按概率调整
有序顺序表的提前失败:
- 若表按递增顺序存储,比较到当前元素
x且 $x>key$ 时,就可立即判定key不在表中;无需扫描后续更大的元素。 - 成功查找仍可能要线性扫描,故最坏时间复杂度仍为 $O(n)$。
- 判定树中,圆形结点通常表示成功关键字,方形外部结点表示落在两个相邻关键字之间或两端的失败结果,共有 $n+1$ 个失败结点。
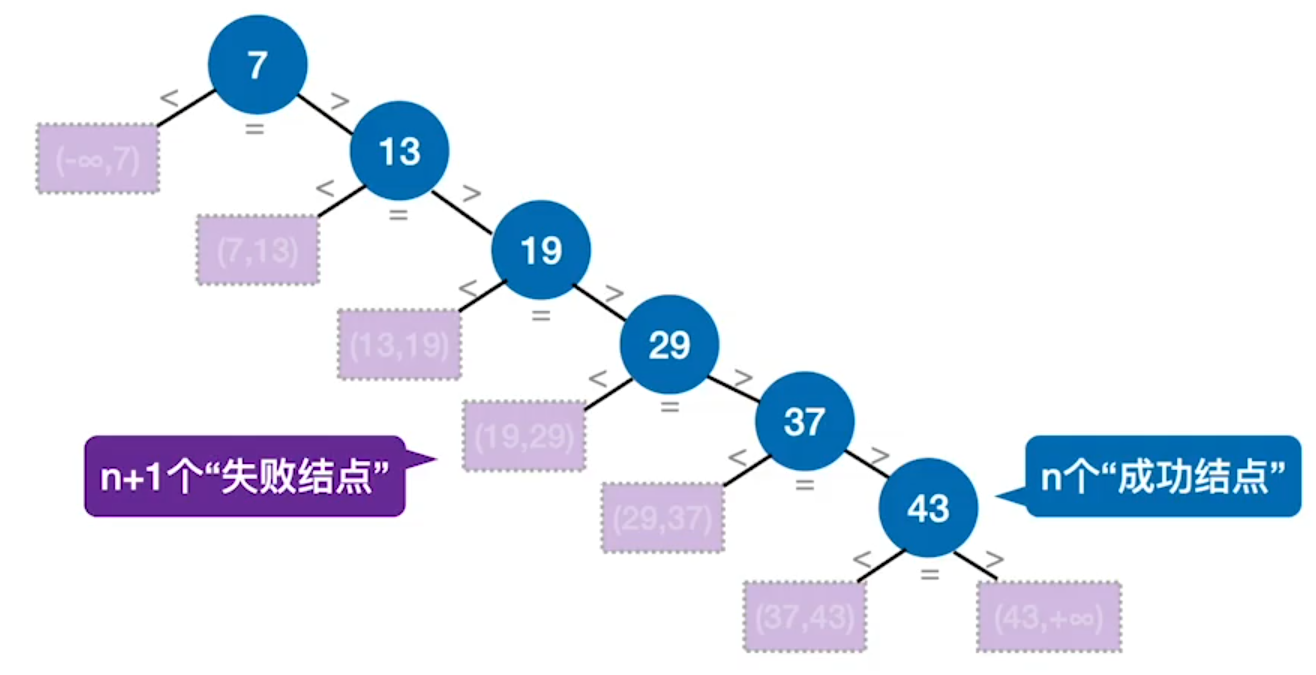
成功结点的查找长度等于所在层数;失败结点本身不再对应一次关键字比较,因此失败查找长度等于其父结点所在层数。
按查找概率排序:
- 访问概率大的记录应靠前放置,以减小 $\sum P_iC_i$。
- 这只能改善成功查找的平均长度;查找失败仍要比较到足以确定不存在的位置。
- 若记录频繁增删或概率会变化,为维持这种次序而付出的成本也应纳入考虑。
例如 6 个关键字的查找概率分别为 $15%,5%,10%,40%,28%,2%$。按概率从大到小排列为 $29,37,7,19,13,43$ 后:
$$ \begin{aligned} ASL_{\text{成功}} &=1\times0.40+2\times0.28+3\times0.15\ &\quad+4\times0.10+5\times0.05+6\times0.02\ &=2.18 \end{aligned} $$
25.2 折半查找
25.2.1 使用条件与过程
定义:#折半查找 #二分查找
描述:在有序表中取中间元素与
key比较;若不相等,则根据大小关系将查找区间缩小到左半或右半,直到找到目标或区间为空。
使用条件:
- 表必须按关键字有序;递增或递减均可,但比较分支必须一致。
- 必须能够直接访问中间位置,因此通常用于顺序表。链表虽有序,却不能在 $O(1)$ 时间定位中点,不能据此获得二分查找的 $O(\log n)$ 效率。
- 若有重复关键字,普通实现返回其中一个匹配位置;要找第一个或最后一个匹配位置时,成功后仍需继续收缩区间。
// L.elem[0..TableLen-1] 按非降序排列
int Binary_Search(SSTable L, ElemType key) {
    int low = 0, high = L.TableLen - 1;
    while (low <= high) {
        int mid = low + (high - low) / 2;
        if (L.elem[mid] == key)
            return mid;
        else if (L.elem[mid] > key)
            high = mid - 1;
        else
            low = mid + 1;
    }
    return -1;
}
循环不变式:
- 每次循环开始时,若
key存在,它一定处于闭区间[low, high]。 L.elem[mid] > key时,mid及其右侧均不可能是目标,故令high=mid-1。L.elem[mid] < key时,mid及其左侧均不可能是目标,故令low=mid+1。- 循环以
low > high结束才表示失败;写成low >= high会漏检仅剩一个元素的区间。
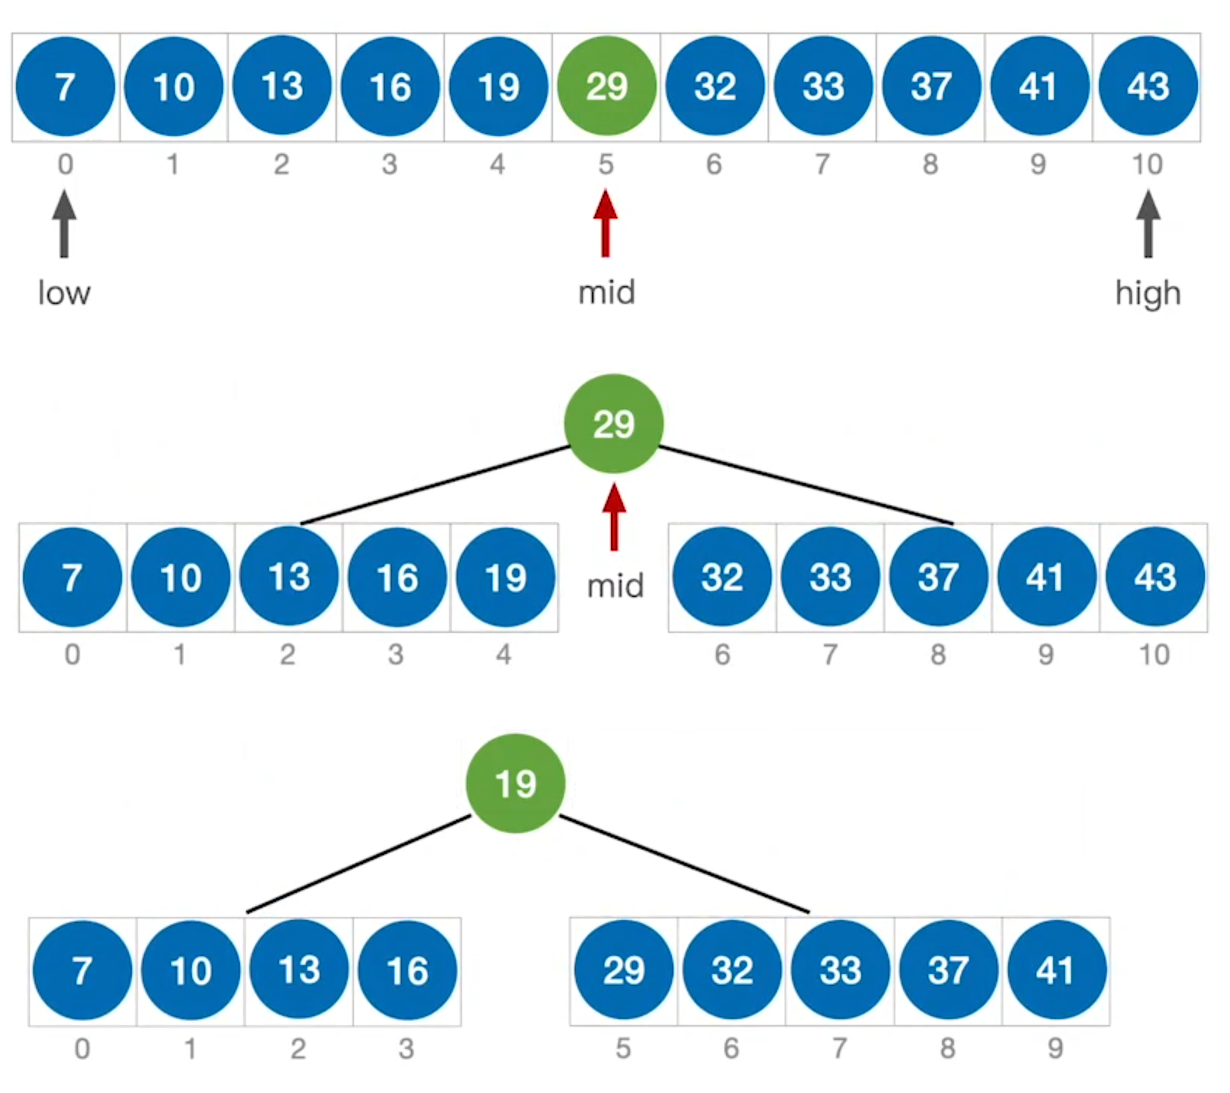
11 个元素时首轮左右各剩 5 个;子区间含偶数个元素时,
mid的取整规则会决定左少右多还是左多右少,并且每个子问题必须沿用同一种规则。
25.2.2 判定树与效率
折半查找判定树:
- 成功结点是表中关键字,所在层数即成功查找长度;失败结点对应关键字之间的 $n+1$ 个空隙。
- 使用
mid=\lfloor(low+high)/2\rfloor时,奇数个元素会被均分;偶数个元素的左半部分比右半部分少一个元素。 - 不同的
mid取整规则会导致左右子树哪边多一个结点不同,但树高和 $O(\log n)$ 量级不变。 - 对不含重复关键字的有序表,判定树同时满足二叉排序树性质;任一结点的左右子树高度差不超过 $1$,但它不一定是完全二叉树。
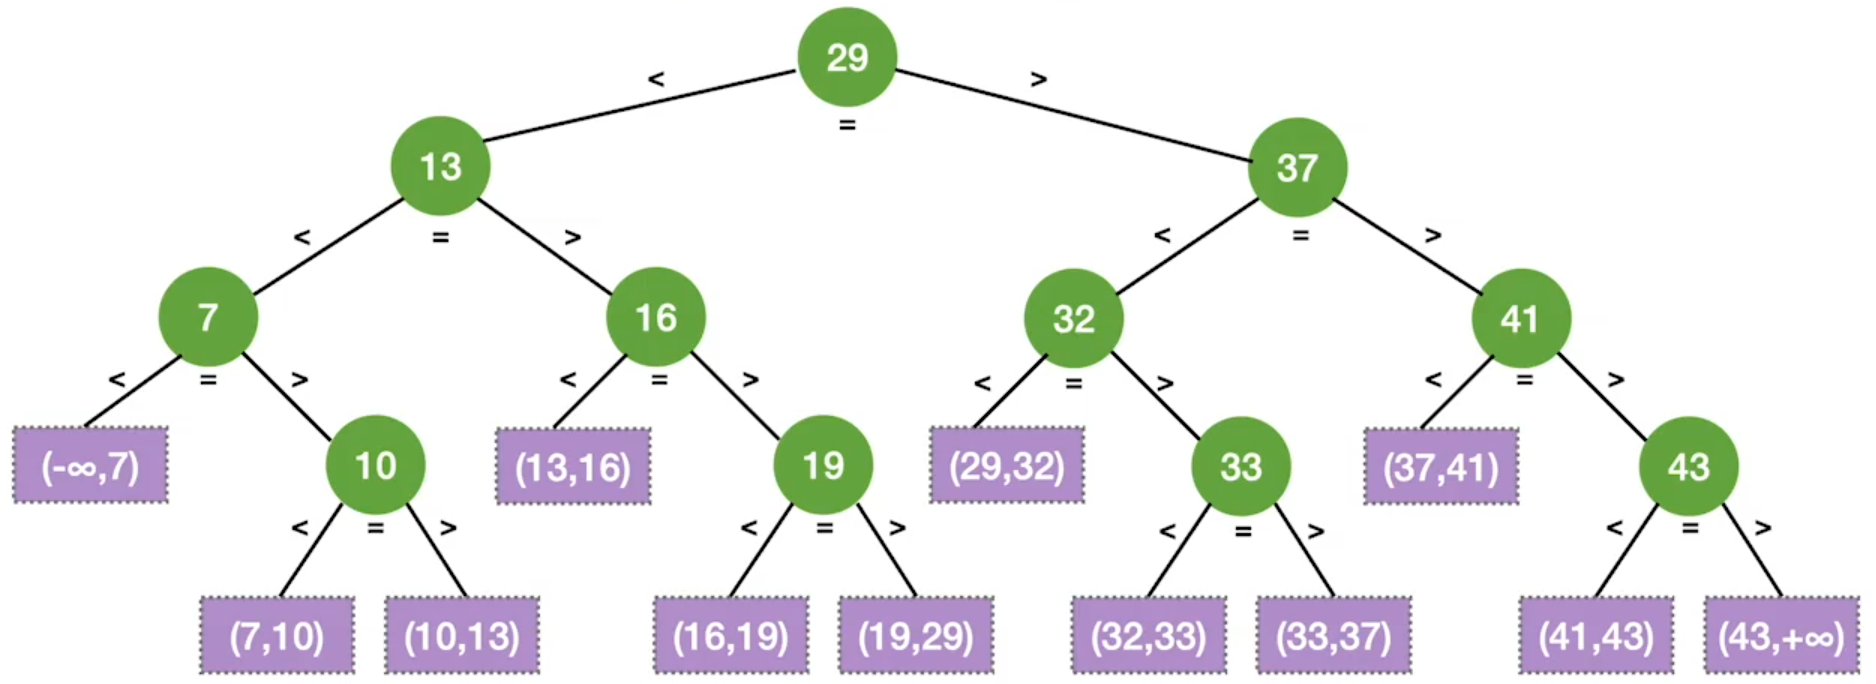
圆形结点是 $n$ 个成功结点,方形外部结点是 $n+1$ 个失败结果。使用向下取整时,偶数规模子问题表现为左少右多。
含 $n\ge1$ 个成功结点时,根按第 $1$ 层计,判定树高度为:
$$ h=\left\lceil\log_2(n+1)\right\rceil $$
因此成功与失败的查找长度均不超过 $h$,折半查找时间复杂度为:
$$ O(\log n) $$
常见误区:
- “有序”是必要条件,但不是充分条件;链表有序也不适合直接二分。
- 折半查找不一定在每个具体样例中都比顺序查找快。例如目标恰在表首,顺序查找只比较一次。
- 判定树的形状由元素个数和
mid规则决定,与关键字具体数值无关;但必须同时满足二叉排序树的大小关系。
题型:#折半查找判定树
第一部分:解题方法
- 根据题目给出的
mid定义确定偶数段是左少右多,还是左多右少。 - 从根结点开始检查:左右子树结点数差必须符合该取整规则;子问题仍用同一规则递归划分。
- 检查中序遍历是否为有序序列;只有“看起来平衡”不足以说明它是正确的折半查找判定树。
- 需要 ASL 时,成功查找用内部结点层数作比较次数;失败查找用到达外部结点前经过的内部结点数作比较次数,再分别按成功或失败结果的概率求平均。
第二部分:典型例题
长度为 $11$ 的有序表,成功结点各层数为 $1,2,4,4$;若各关键字等概率被查找,则:
$$ ASL_{\text{成功}}= \frac{1\times1+2\times2+3\times4+4\times4}{11}=3 $$
若 $12$ 个失败区间等概率被查找,其中 $4$ 个需比较 $3$ 次、$8$ 个需比较 $4$ 次,则:
$$ ASL_{\text{失败}}= \frac{3\times4+4\times8}{12}=\frac{11}{3} $$
若根结点记为第 $1$ 层,图中对应的外部失败结点实际上分别位于第 $4$、$5$ 层;外部结点本身不进行关键字比较,因此不能把外部层数直接代入分子。
第三部分:2017 统考判定树辨析
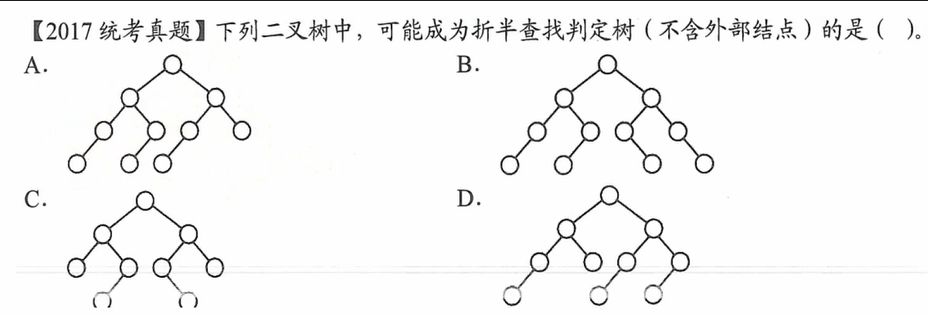
答案为 A。题目只问“可能”,没有限定 mid 的取整方向;A 的根左右子树分别有 $5$ 和 $4$ 个结点,可视为采用向上取整。继续递归检查时,规模相同的子问题结构一致,偶数规模也始终保持左多右少。其余选项会在某一层出现“相同规模却结构不同”或前后取整规则不一致。若题目明确限定本节代码的向下取整,则应始终按左少右多检查。
25.3 分块查找
25.3.1 结构与过程
定义:#分块查找 #索引顺序查找
描述:将查找表分成若干块,建立索引表。索引表记录每块的最大关键字和该块的存储范围;查找时先在索引表确定目标块,再在块内顺序查找。
- 块间有序:前一块的最大关键字小于后一块的最小关键字;各块在物理位置上不要求整体连续递增。
- 块内可无序:因此进入块后一般使用顺序查找。
- 索引表本身可用顺序查找,也可用折半查找;后者要求索引表有序且可随机访问。
typedef struct {
    ElemType maxValue;
    int low, high;  // 对应块在实际顺序表中的边界
} Index;
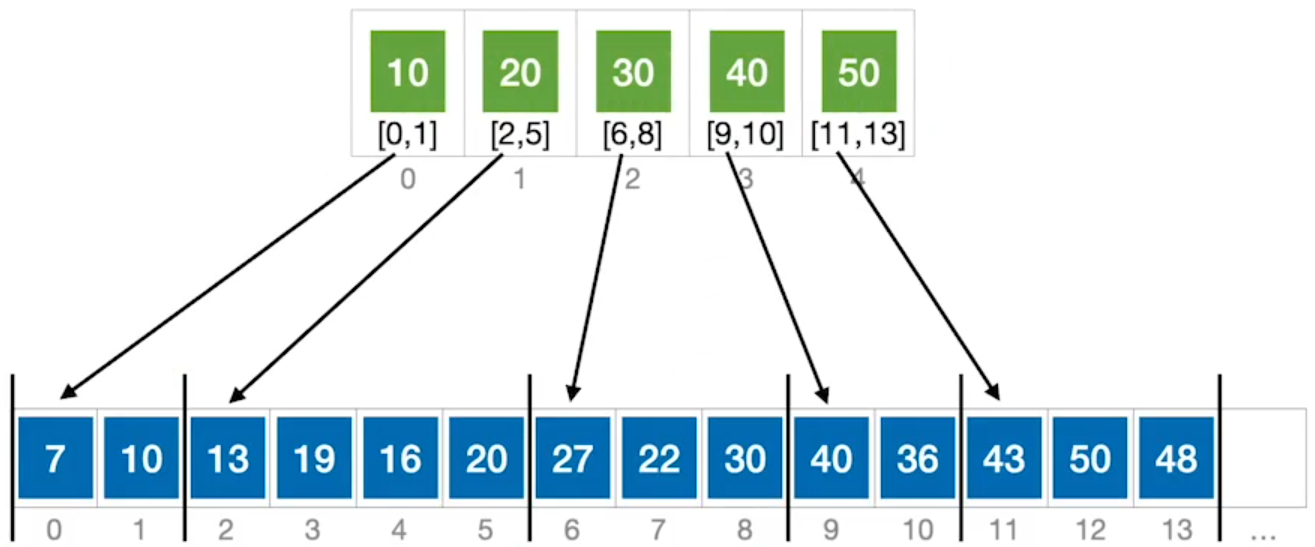
索引项保存块内最大关键字和块的边界。先找到第一个“最大关键字不小于
key”的索引项,再只在对应块内顺序查找。
源 PDF 图中的 14 个元素分为 5 块,索引最大值和区间依次为 10:[0,1]、20:[2,5]、30:[6,8]、40:[9,10]、50:[11,13]。例如查找 27 时,第一个最大值不小于 27 的索引项是 30:[6,8],只需在该块的 27,22,30 中顺序查找,而不必扫描其他块。
25.3.2 均匀分块的 ASL
设表长为 $n$,均分为 $b$ 块,每块有 $s$ 个元素,则 $n=bs$。在成功查找、各记录等概率,且索引表和块内都采用顺序查找时:
$$ \begin{aligned} ASL_{\text{成功}} &= ASL_{\text{索引}}+ASL_{\text{块内}}\ &=\frac{b+1}{2}+\frac{s+1}{2}\ &=\frac{n}{2s}+\frac{s}{2}+1 \end{aligned} $$
将 $s$ 暂按正实数处理,算式在 $s=\sqrt n$ 时取得理论最小值:
$$ ASL_{\min}=\sqrt n+1 $$
- 这个结论有前提:均匀分块、等概率、两阶段都顺序查找。
- 实际块长 $s$ 和块数 $b$ 必须是整数;若还要求 $n=bs$ 且每块完全等长,应在可行的整数分块方案中选接近 $\sqrt n$ 的值。$\sqrt n+1$ 是连续变量模型的下界,不保证任意 $n$ 都能恰好达到。
- 不要把分块查找简单记成 $O(\sqrt n)$ 后就忽略块数、索引方式和实际分布;题目条件改变时需重新计算。
相关知识
- 科目导航:数据结构导航
- 阅读顺序:上一篇:查找的基本概念 · 下一篇:树形查找
- 关联专题:查找代码
25.4 本节复盘
- 顺序查找适用面最广,等概率成功时 $ASL=\frac{n+1}{2}$,时间复杂度 $O(n)$。
- 折半查找要求有序顺序表,每次缩小一半区间,时间复杂度 $O(\log n)$。
- 分块查找在“块间有序、块内无序”之间折中;均匀分块的最佳块长约为 $\sqrt n$。
- 先判断前提,再讨论效率;不要只因“有序”或“树很平衡”就跳过具体实现条件。