Lecture 28:散列查找
Chinese-language Computer Science 408 note: Lecture 28:散列查找. Original source available where applicable.
On this page
This note is currently available in Chinese. The original wording, formulas and diagrams are preserved to avoid an unverified technical translation.
散列查找不通过比较树或有序位置逐层缩小范围,而是先用散列函数把关键字映射到地址。理想查找近似 $O(1)$。当整个关键字域大于有限地址域时,映射整体上必然存在碰撞;但某个具体插入集合仍可能恰好没有冲突。构造函数、控制装填因子、选对冲突处理方法才是题目的重点。
28.1 散列表基础
28.1.1 散列函数与冲突
定义:#散列表 #散列函数
描述:散列表(Hash Table)按散列函数 $H$ 将关键字映射到表中地址:$\text{Addr}=H(\text{key})$。通过地址直接访问记录的查找方式称为散列查找。
$$ \text{Addr}=H(\text{key}) $$
- 理想情况下,计算地址后一次访问就能找到记录,查找、插入和删除的期望时间可接近 $O(1)$。
- 关键字取值空间通常远大于表地址空间,$H$ 在整个关键字域上不可能一一映射,因此必然存在某些关键字对发生碰撞;对当前实际插入的有限关键字集合,冲突并非每次都必然出现。
- 不同关键字映射到同一初始散列地址时,这些关键字互称为同义词。
- $O(1)$ 是散列均匀且装填因子受控时的期望量级,不是无条件最坏界;大量关键字集中到同一链或同一探测簇时,单次操作最坏可退化为 $O(n)$。
定义:#装填因子
描述:装填因子 $\alpha$ 表示散列表已存记录数与表长之比:
$$ \alpha=\frac{n}{m} $$
- $n$ 为表中记录数,$m$ 为散列表长度。
- $\alpha$ 越大,地址拥挤、冲突概率和平均探测长度通常越大。
- 拉链法中 $\alpha$ 可以大于 $1$;开放定址法必须有空位才可继续插入,通常要求 $\alpha<1$。
28.1.2 好的散列函数
| 要求 | 含义 |
|---|---|
| 定义域完整 | 能处理所有可能关键字,不能因负数、字符或特殊格式失效 |
| 值域合法 | 输出必须落在地址范围内,通常为 $0\sim m-1$ |
| 分布均匀 | 尽量减少同义词,避免大量关键字落入少数地址 |
| 计算简单 | 函数本身不能比查找还昂贵 |
- 散列函数只能减少冲突,不能保证消灭冲突;题目中声称“完全不会冲突”时,需检查关键字范围和地址空间是否确能一一对应。
- 插入、查找、删除必须使用同一个 $H$ 和同一种冲突处理规则,否则无法沿正确位置或探测序列定位记录。
28.2 常用散列函数构造
28.2.1 除留余数法
定义:#除留余数法
$$ H(\text{key})=\text{key}\bmod p $$
- $p$ 应取不大于表长 $m$ 且尽量接近 $m$ 的质数(素数)。例如 $m=15$ 时可取 $p=13$。
- 质数取模通常能避免关键字分布规律与表长存在不良公因数,从而改善均匀性。
- 地址空间以 $0\sim m-1$ 为准;$p<m$ 时,部分地址可能不由初始散列函数直接产生,但开放定址的后续探测仍可能访问它们。
- 教材补充:若允许负关键字,需注意某些语言的
%会得到负余数;作为数组地址时应归一化为((key % p) + p) % p,保证结果落在 $0\sim p-1$。
28.2.2 直接定址法
定义:#直接定址法
$$ H(\text{key})=\text{key} \quad\text{或}\quad H(\text{key})=a\times\text{key}+b $$
- 若关键字本身连续或近似连续,直接定址计算快且可避免冲突。
- 若关键字稀疏,例如学号跨度很大而记录很少,会产生大量空位,空间利用率低。
- “不会冲突”要求该线性映射在实际关键字集合上是一一映射,且结果全部落入合法地址范围;若 $a=0$、结果被再次取模或超界截断,仍可能冲突,不能只见到 $a\times key+b$ 就直接判无冲突。
28.2.3 数字分析法与平方取中法
数字分析法:
- 观察已知关键字各数位的分布,选取分布较均匀的若干位组成地址。
- 适合关键字集合已知、各位分布差异明显的场景,例如号码、编码类关键字。
- 不能机械取“最后几位”;若最后几位集中或有固定前后缀,冲突反而会增多。
平方取中法:
- 先求关键字平方,再取中间若干位作为地址。
- 平方结果的中间位受原关键字多个数位共同影响,适合各位都不够均匀、又不易直接挑选有效位的情况。
- 取几位仍由表长决定,结果必须映射到合法地址范围。
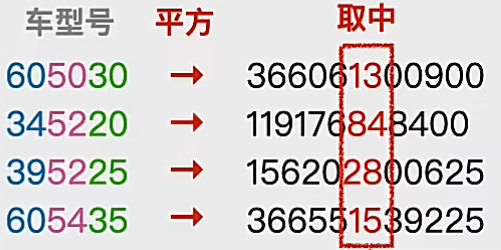
图中不同车型号平方后,中间若干位同时受原关键字多位影响;实际取几位由地址空间大小决定,不能固定照抄图中的位数。
28.3 拉链法
28.3.1 结构与操作
定义:#拉链法 #链地址法
描述:为散列表的每个地址建立一个链表,将初始地址相同的所有同义词链接在该链表中。
table[i] -> 记录1 -> 记录2 -> ... -> NULL
插入、查找、删除:
- 计算初始地址 $i=H(key)$。
- 插入时把新记录接入
table[i]对应链表(头插或尾插都可以,但顺序会影响具体查找长度)。 - 查找时仅在该链表中顺序比较关键字;链表结束仍未命中则失败。
- 删除时在链表中找到目标后修改前驱指针或表头指针即可。
原 PDF 的删除图例中,$H(key)=key\bmod13$:桶 1 的链上可删除 $27$,桶 7 可删除 $20$;$66\bmod13=1$,但桶 1 链中没有 $66$,查找失败,因此也不能删除 $66$。删除一个结点不影响同桶其余结点的可查找性。
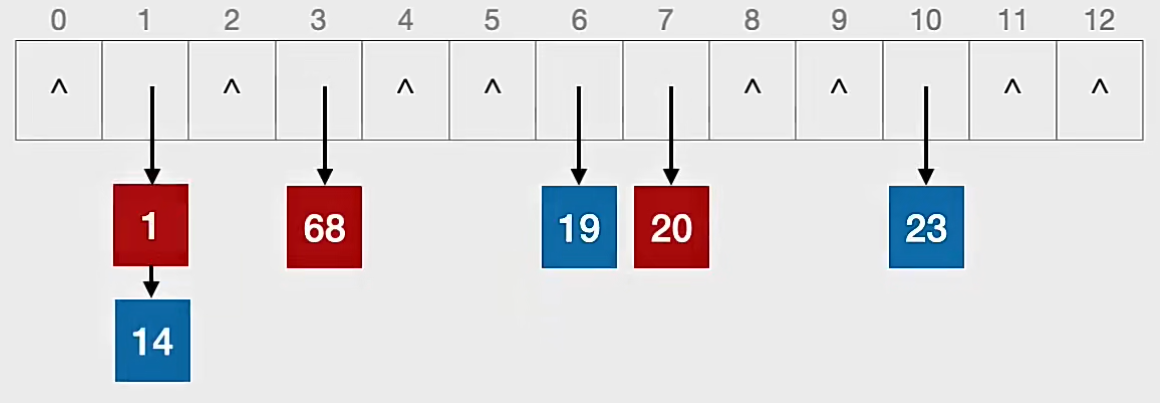
以 $m=13,H(key)=key\bmod13$ 为例,依次插入 $19,14,23,1,68,20$;若采用头插法,地址 $1$ 的链为 $1\to14$,地址 $3$ 存 $68$,地址 $6$ 存 $19$,地址 $7$ 存 $20$,地址 $10$ 存 $23$。
- 表头为空时,查找可立即失败。
- 链表长度就是该地址的冲突程度;若散列均匀,平均链长约为 $\alpha$。
- 在均匀散列的常见分析下,拉链法的期望查找代价为 $O(1+\alpha)$。
查找长度口径:
- 408 题通常统计关键字比较次数;是否把链表末尾的空指针比较计入,以题目说明为准。
- 不能把“计算散列地址”自动算成一次关键字比较,除非题目明确要求统计函数计算或访问次数。
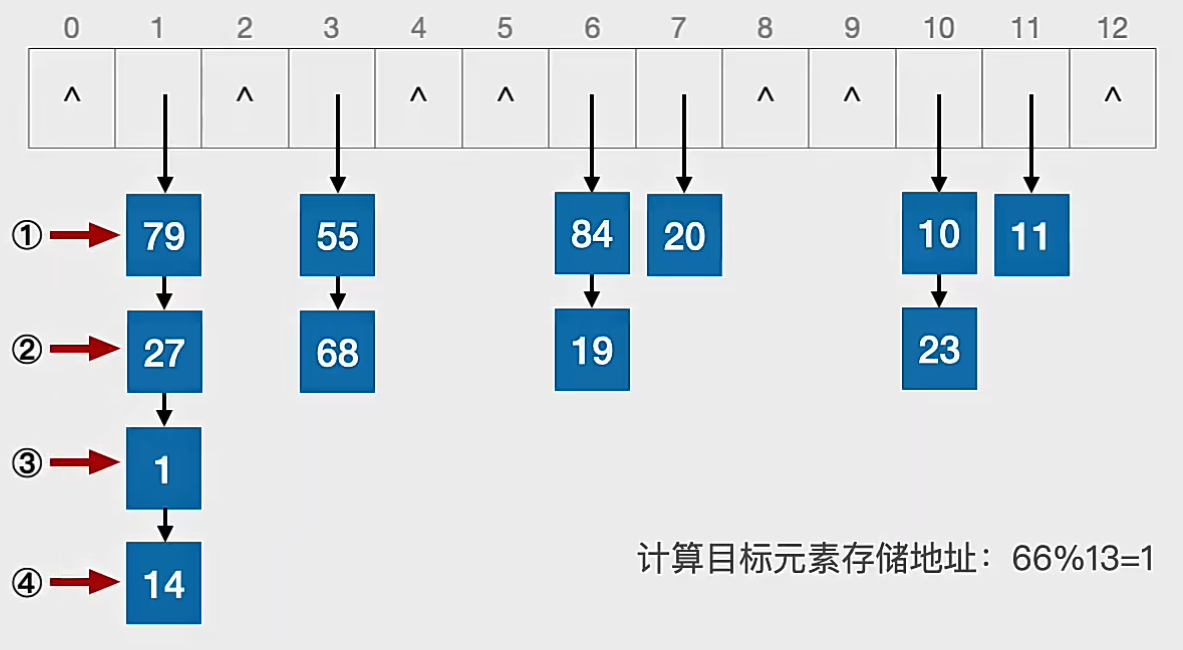
图中查找 $66$,初始地址为 $66\bmod13=1$,依次比较 $79,27,1,14$ 后失败;按“只计关键字比较”口径,失败查找长度为 $4$。
28.4 开放定址法
28.4.1 通用探测公式
定义:#开放定址法
描述:发生冲突时,不另建链表,而是按约定探测序列在散列表的其他单元中寻找空位置。表内任一地址都可能存放来自其他初始地址的记录。
$$ H_i=(H(\text{key})+d_i)\bmod m $$
- $H(\text{key})$ 是初始散列地址,$d_i$ 是第 $i$ 次探测的偏移量,$m$ 是表长。
- 插入和查找都必须按完全相同的探测序列进行:查找碰到空单元才可判定失败;碰到其他关键字只说明继续探测。
- 开放定址法记录都在表数组内,装填因子升高时探测长度会明显变大。
28.4.2 四种探测方法
| 方法 | 偏移序列 | 特点 |
|---|---|---|
| 线性探测 | $d_i=0,1,2,\ldots,m-1$ | 简单,若表长合适可遍历全表;易产生一次聚集 |
| 平方探测 | $0^2,1^2,-1^2,2^2,-2^2,\ldots$ | 可缓解线性连续堆积;覆盖范围取决于表长,不能无条件声称至少一半或覆盖全表 |
| 双散列 | $d_i=i\times H_2(key)$ | 第二函数与表长互质时可覆盖全表,聚集较少 |
| 伪随机探测 | 按预设伪随机偏移序列 | 覆盖能力取决于序列设计,必须可重复 |
线性探测法:
- 连续同义词会依次占据相邻位置,后来即使初始地址不同的关键字也可能被挤入这一段,称为一次聚集(primary clustering)。
- 优点是规则直观;缺点是聚集会让成功和失败查找都变慢。
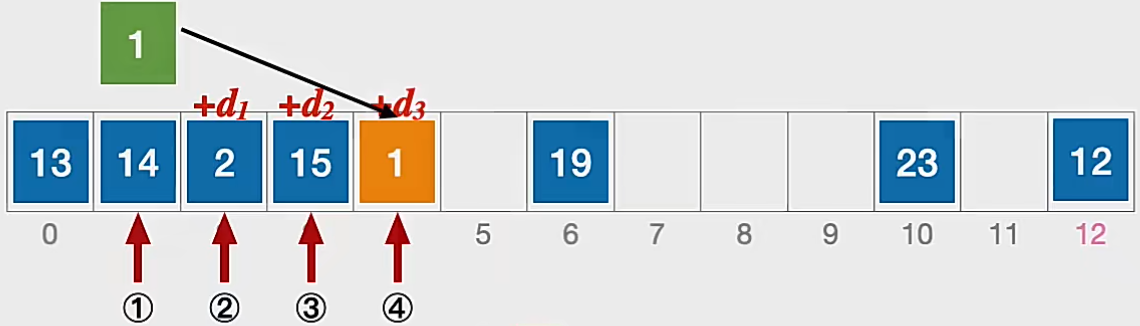
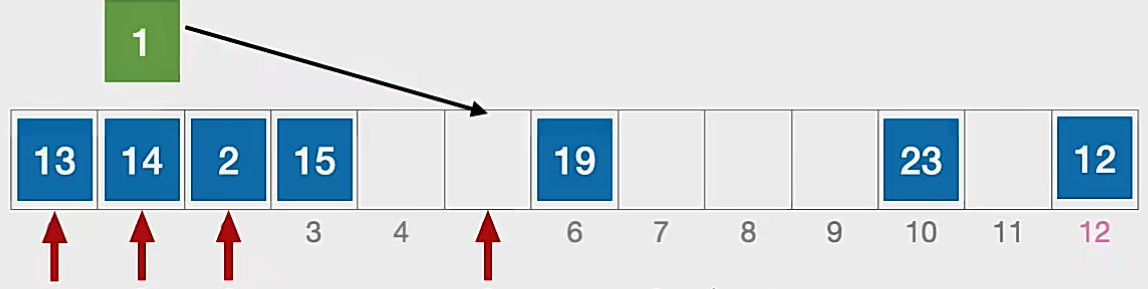
例如 $m=13,H(key)=key\bmod13$,插入 $1$ 时依次访问地址 $1,2,3,4$,前三处已被 $14,2,15$ 占用,最终存入地址 $4$。
平方探测的覆盖边界:
- 对 $d_i=0,1^2,-1^2,2^2,-2^2,\ldots$,若 $m$ 是形如 $4j+3$ 的质数,可以覆盖全部地址;若 $m$ 是形如 $4j+1$ 的质数,只会得到约一半的不同地址。
- 教材常说“至少能探测一半”时,隐含了表长取合适质数等条件;对于任意合数表长,这个结论并非无条件成立。
- 图中插入 $1$ 时从地址 $1$ 出发,依次按 $+1^2,-1^2,+2^2$ 访问 $2,0,5$,最终落在地址 $5$。
双散列法的覆盖条件:
- 若 $\gcd(H_2(key),m)=1$,探测步长与表长互质,才能遍历全部 $m$ 个地址。
- “双散列一定能访问全表”是错误的;需检查步长和 $m$ 的最大公因数。
- 原稿示例采用 $H_2(key)=m-(key\bmod m)$。它对图中的 $m=13,key=1$ 给出步长 $12$,确实与 $13$ 互质;但若 $key\bmod m=0$,会得到步长 $m\equiv0\pmod m$,探测将停在原地址,因此这个公式并非对所有关键字都安全。
- 更稳妥的常见设计是取小于 $m$ 的质数 $R$,令 $H_2(key)=R-(key\bmod R)$,并逐题验证 $\gcd(H_2(key),m)=1$;当 $m$ 为质数时,也可令 $H_2(key)=1+(key\bmod(m-1))$。
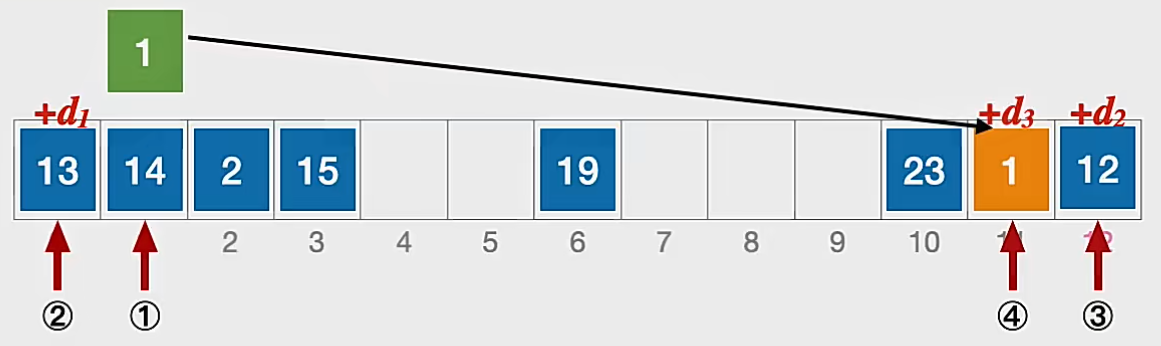
图中 $m=13,key=1,H_2=12$,探测地址依次为 $1,0,12,11$,最终插入地址 $11$。
伪随机探测法:
- 所谓“随机”必须由可重复的伪随机偏移序列给出,插入和查找才能重现同一路径;覆盖能力仍取决于序列在模 $m$ 后产生多少个不同地址。
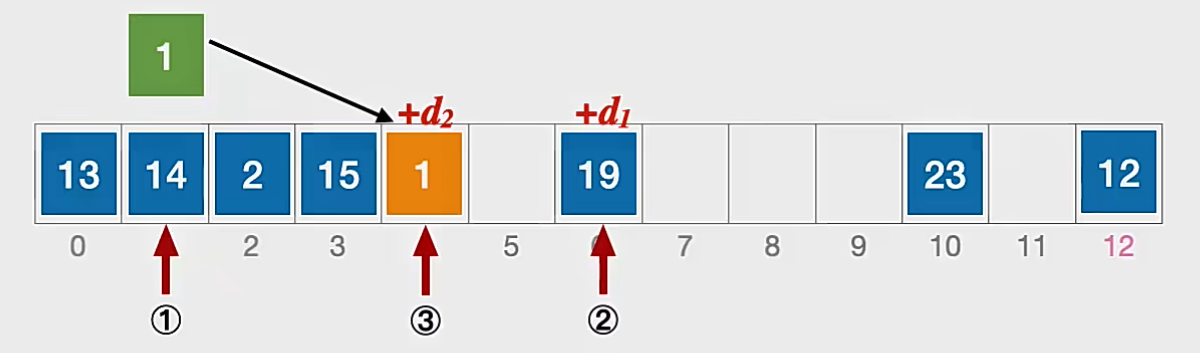
- 图中偏移序列从 $0,5,3,\ldots$ 开始,插入 $1$ 时先查地址 $1$,再查 $6$,最后在地址 $4$ 成功插入。
- 原 PDF 第 9 页文字把序列写为 $0,3,5,11$,但同页图和算式依次使用 $+5$、$+3$;图示结果 $1\to6\to4$ 只与 $0,5,3,11$ 相符。遇到这种原稿内部不一致,应按题目实际给定的序列逐项计算。
28.4.3 查找长度与 ASL 手算
- 成功查找长度:对每个已存关键字,从它自己的初始地址开始,按规定探测序列重放,直到命中;访问了几个表项,就记几次比较。不能简单用“最终地址减初始地址”。
- 失败查找长度:从题目指定的每个初始地址开始探测,直到首次遇到“从未使用”的空单元;墓碑标记不能终止失败查找。若探测序列先重复,则说明该序列覆盖范围已耗尽。
- 成功 ASL 的分母通常是表中关键字数;失败 ASL 的分母可能是题目指定的若干初始地址数或散列函数值域大小,必须按题干口径。
- 线性探测可以把连续被占用区间视为聚集簇辅助计数,但平方探测、双散列和伪随机探测必须逐个关键字重放,不能沿数组连续数格。
28.4.4 删除不能直接清空
定义:#删除标记 #墓碑标记
描述:开放定址法删除记录时,应把该位置标记为“已删除”,而不能立刻改成“从未使用的空单元”。
原因是:后续冲突记录可能正是沿探测序列越过该位置存入的。若直接清空,查找在这里提前停止,会误判后面的记录不存在。
正确处理:
- 查找遇到“已删除”标记时继续探测;遇到真正从未使用的空单元才失败。
- 插入可记住第一个已删除位置,但仍应继续按探测序列确认不存在同键记录,再决定是否复用该位置。
- 删除标记过多会使探测变长,实际系统会在合适时机重散列;408 手算题按给定表状态和规则模拟即可。
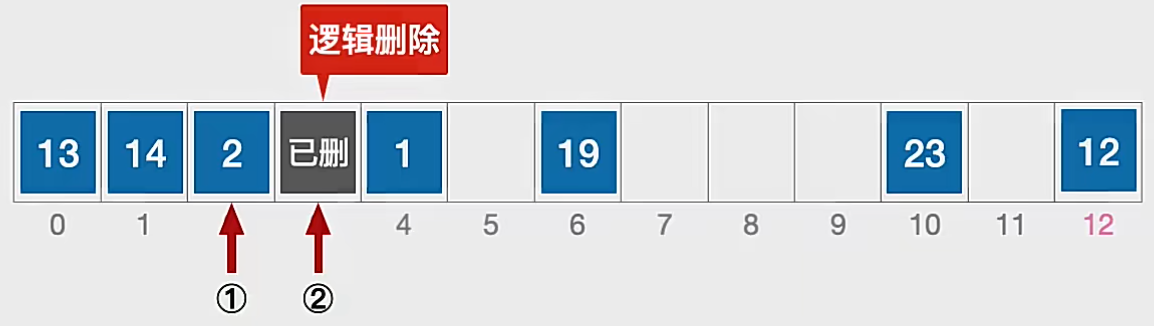
图中地址 $3$ 已逻辑删除。随后查找 $1$ 时仍须越过该墓碑并继续到地址 $4$;若把地址 $3$ 直接清空,查找会在此提前失败。
题型:#散列插入查找删除
第一部分:解题方法
- 先写出 $H(key)$,得到初始地址;不要跳过取模过程。
- 若冲突,严格列出 $d_i$ 和每次 $H_i$,每访问一个单元都检查其状态。
- 查找仅在命中目标或遇到真正空单元时结束;插入遇到真正空单元即可确定终点,遇到墓碑则先记住候选位置,并继续确认后面不存在同键记录。
- 删除题标明“删除标记”,不要把开放定址单元直接涂成空白。
第二部分:易错点
- 同义词指初始地址相同的关键字;在线性探测中占到同一连续区的记录不一定互为同义词。
- 拉链法的删除可直接断链;开放定址法的删除必须保留探测链。
- 平方探测、双散列、伪随机法是否能遍历全表取决于参数,不能只凭名称下结论。
相关知识
- 科目导航:数据结构导航
- 阅读顺序:上一篇:B 树 · 下一篇:排序基本概念
- 关联专题:查找代码
28.5 本节复盘
- 散列查找用 $\text{Addr}=H(key)$ 直接定位;整个关键字域到有限地址域的映射无法消除所有潜在碰撞,但某个具体插入集合可以没有实际冲突。
- 装填因子 $\alpha=\frac{n}{m}$ 越大,平均探测或链长通常越大。
- 拉链法把同义词放在同一链表;开放定址法按探测序列找表中空位。
- 开放定址删除采用墓碑标记,确保后续记录的探测路径不断裂。