Lecture 33:归并排序与基数排序
408 学习笔记:Lecture 33:归并排序与基数排序。保留原有知识内容、公式与图示;有对应原件时提供查看和下载入口。
本页目录
归并排序先把问题分成小序列,再把有序子序列合并;基数排序则不直接比较完整关键字,而是按关键字的各“位”稳定地分配和收集。两者都能达到稳定排序,但依赖的辅助空间和适用条件不同。
NOTE · 源文件题名纠正 原 PDF 文件名写作“归并排序与基准排序”,但后半部分内容、算法步骤和复杂度全部属于“基数排序(radix sort)”。“基准”通常用于快速排序的枢轴语境,不能与基数排序混为一谈;本笔记正文使用正确名称,
source仍保留原文件路径以便追溯。
33.1 二路归并与归并排序
33.1.1 归并操作
定义:#归并
描述:归并是把两个或多个已经有序的序列合并成一个有序序列。二路归并每次比较两个子序列当前最前元素,输出较小者。
#include <stdlib.h>

void Merge(int A[], int B[], int low, int mid, int high) {
    for (int k = low; k <= high; ++k) B[k] = A[k];
    int i = low, j = mid + 1, k = low;
    while (i <= mid && j <= high) {
        if (B[i] <= B[j]) A[k++] = B[i++]; // 相等时先取左表,保持稳定
        else              A[k++] = B[j++];
    }
    while (i <= mid) A[k++] = B[i++];
    while (j <= high) A[k++] = B[j++];
}
- 某一子表耗尽后,另一子表的剩余元素本身已有序,可直接复制,不必继续逐个比较。
- 长度分别为 $n_1,n_2$ 的两个有序表,二路归并最坏只需 $n_1+n_2-1$ 次关键字比较;但某个尚未输出的元素可能连续与另一表的多个元素比较,不能说“每个元素最多比较一次”。
- $k$ 路直接比较各路当前首元素选最小值时,每输出一个元素最多需 $k-1$ 次比较,因此内部合并通常优先二路,外部排序再结合败者树和 I/O 趟数权衡。
B[i] <= B[j]时先取左侧,才能保证左表中原先靠前的相等记录不被右表记录越过;若写成严格<并在相等时取右侧,则归并排序不稳定。
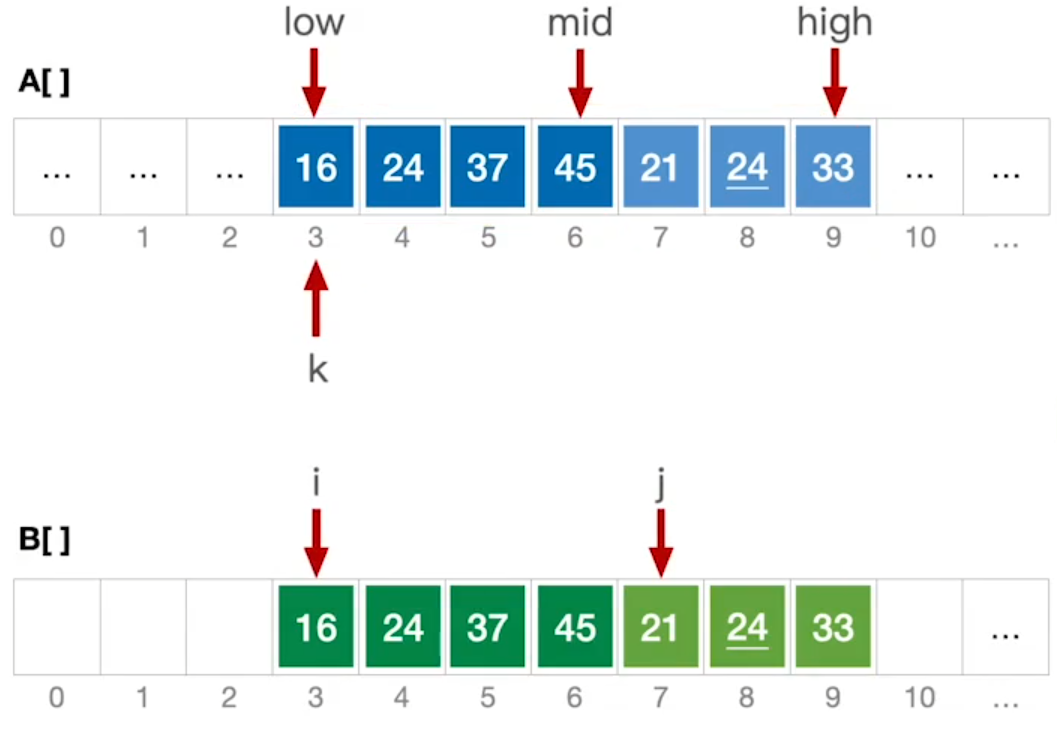
i、j分别指向左右有序子表当前元素,k指向输出位置。每次只移动被选中一侧的指针和k;任一侧耗尽后,另一侧剩余部分直接复制。
33.1.2 递归归并排序
static void MergeSortRange(int A[], int B[], int low, int high) {
    if (low >= high) return;
    int mid = low + (high - low) / 2;
    MergeSortRange(A, B, low, mid);
    MergeSortRange(A, B, mid + 1, high);
    Merge(A, B, low, mid, high);
}

int MergeSort(int A[], int n) {
    if (n <= 1) return 1;
    int *B = malloc((size_t)n * sizeof *B);
    if (B == NULL) return 0;
    MergeSortRange(A, B, 0, n - 1);
    free(B);
    return 1;
}
-
两段代码连用,以
MergeSort(A, n)为入口;调用时 $n\ge0$,A至少有 $n$ 个元素。返回1表示排序完成,返回0表示辅助数组分配失败;B由入口分配一次并在结束后释放。示例以整数关键字展示,若记录含其他字段,应整体复制记录、仅比较其关键字。 -
递归到单元素区间时天然有序;回溯时做归并。
-
第 $t$ 层有若干次归并,但每层合并的总元素数不超过 $n$,故每层代价为 $O(n)$。
-
递归层数为 $\lceil\log_2n\rceil$,因此时间复杂度为:
$$ O(n\log n) $$
- 辅助数组 $B$ 需要 $O(n)$ 空间;递归栈为 $O(\log n)$,总体辅助空间量级为 $O(n)$。
- 归并排序稳定,时间复杂度不受初始序列有序程度影响;代价是不能像堆排序那样只用 $O(1)$ 辅助空间完成标准数组实现。
33.2 基数排序
33.2.1 多关键字与链式基数排序
定义:#基数排序 #多关键字排序
描述:将每个关键字拆成 $d$ 个位(或组)$\left(k_{d-1},\ldots,k_1,k_0\right)$,每一位取值范围为 $0\sim r-1$。基数排序对每一位依次做稳定的“分配—收集”。
以最低位优先(LSD)升序为例:
- 建立 $r$ 个空队列 $Q_0,Q_1,\ldots,Q_{r-1}$。
- 从低位到高位依次处理每一关键字位。
- 顺序扫描当前序列,当前位为 $x$ 的记录进入 $Q_x$ 的队尾。
- 按 $Q_0\to Q_{r-1}$ 的顺序依次出队、重新链接为新序列。
- 队尾入队、队首出队保证同一位取值相同的记录原有相对次序不变;每一趟稳定是 LSD 正确性的必要条件。
- 第一趟按最低位有序;第二趟按次低位有序,并在次低位相同者内部保留最低位次序;处理至最高位后得到整体有序。
- 若要求降序收集,应按 $Q_{r-1}\to Q_0$ 收集,且每个队列内部仍需保持先进先出。
原稿三位十进制降序例题:
初始序列为:
$$ 520,211,438,888,007,111,985,666,996,233,168 $$
采用 LSD,并按 $Q_9\to Q_0$ 收集实现降序:
- 按个位稳定分配,$Q_8$ 中依次为 $438,888,168$,$Q_6$ 中依次为 $666,996$;队内顺序必须保持。
- 个位收集后得到 $438,888,168,007,666,996,985,233,211,111,520$。
- 再按十位分配、收集,得到 $996,888,985,168,666,438,233,520,211,111,007$。
- 最后按百位稳定分配、收集,得到完整降序结果。
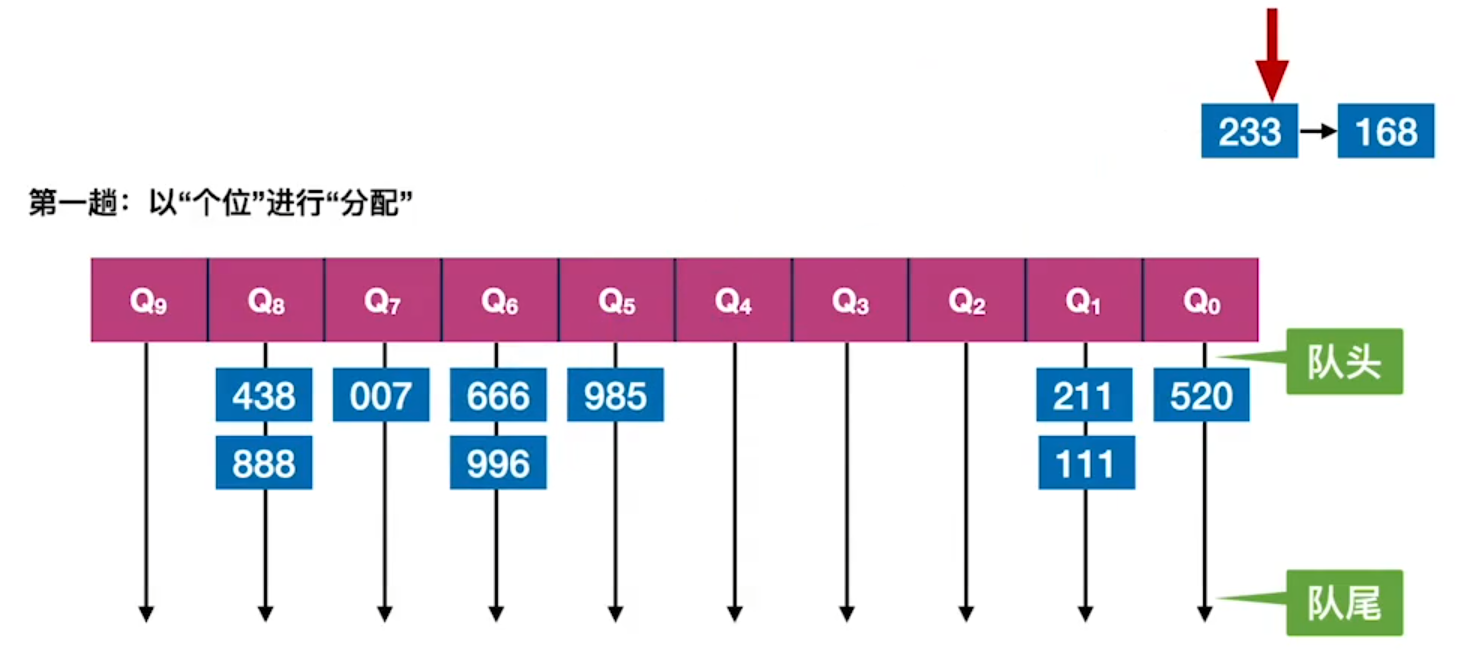
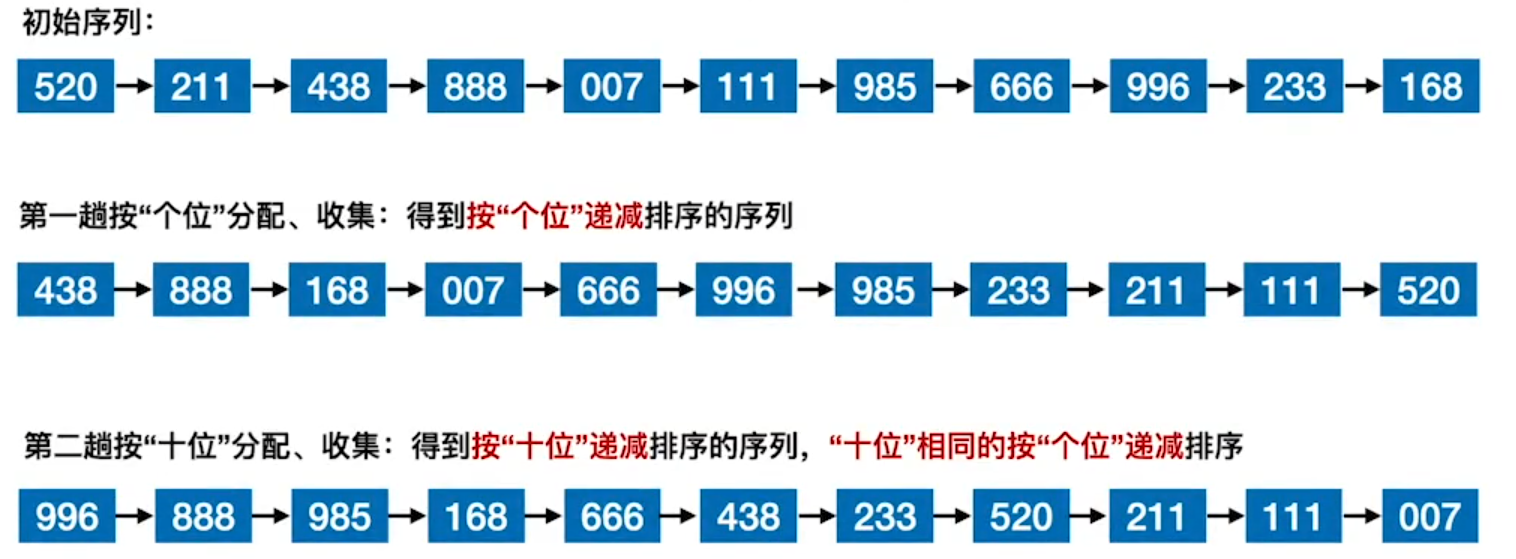

最终序列为:
$$ 996,985,888,666,520,438,233,211,168,111,007 $$
007必须按三位关键字处理,不能先转成不带前导零的文本后再按字符长度比较。
LSD 与 MSD 的区别:
- LSD 从最低位到最高位,每一趟对整个序列稳定分配和收集,适合位数固定的数值或定长编码。
- MSD 从最高位开始,收集后要在每个桶内部递归处理下一位;它不是把全表按下一位再次统一分配,否则会破坏已经确定的高位次序。
33.2.2 复杂度与适用条件
$$ T(n)=O\bigl(d(n+r)\bigr) $$
- 每一位需要扫描 $n$ 个记录并访问 $r$ 个队列,累计处理 $d$ 位。
- 队列头、尾指针等辅助信息为 $O(r)$;链式实现通常复用原记录结点,不需搬动完整记录,但仍需维护 $r$ 个队列。
- 基数排序稳定,且不是基于关键字比较的排序。
适用条件:
- 关键字能方便拆成 $d$ 组,且 $d$ 较小。
- 每组的基数 $r$ 不宜过大,否则队列数量和每趟收集成本会升高。
- 数据量 $n$ 较大时才能体现 $O(d(n+r))$ 的优势;不能将任意长、任意格式字段不加分析地套入基数排序。
题型:#归并与基数排序过程
第一部分:解题方法
- 归并题先写出两个子表是否各自有序,再按“比较首元素—输出较小者—移动对应指针”执行。
- 基数题明确 LSD 或 MSD、升序或降序;每一趟都列出各队列分配结果和收集顺序。
- 稳定性题不要只背结论:归并看相等时先取哪边,基数看每趟是否保持队列内次序。
相关知识
33.3 本节复盘
- 二路归并合并两个有序表;标准归并排序时间 $O(n\log n)$、空间 $O(n)$、稳定。
- 基数排序按位稳定地分配与收集,时间 $O(d(n+r))$,适合位数和基数较小的结构化关键字。
- 两类算法都需要辅助结构;要区分“稳定的队列收集”和“相等时优先左表”这两个稳定性来源。