Lecture 8:队列基本概念
408 学习笔记:Lecture 8:队列基本概念。保留原有知识内容、公式与图示;有对应原件时提供查看和下载入口。
本页目录
8.1 队列的定义
定义:#队列
描述: 队列是只允许在一端进行插入、在另一端进行删除的线性表。
解释
- 队列本质上仍然是线性表。
- 队列的限制在于:
- 一端只能插入;
- 另一端只能删除。
- 队列的处理规则是先进先出: $$ \text{FIFO}=\text{First In First Out} $$
重要术语
- 队头: $$ \text{Front} $$
- 队尾: $$ \text{Rear} $$
- 空队列:不含任何元素的队列。
队头和队尾
- 队头通常是允许删除的一端。
- 队尾通常是允许插入的一端。
- 新元素从队尾进入。
- 旧元素从队头离开。
8.2 队列的基本操作
8.2.1 初始化和销毁
初始化
InitQueue(&Q);
- 作用:初始化队列。
- 含义:
- 构造一个空队列
Q; - 设置队头、队尾等初始状态。
- 构造一个空队列
销毁
DestroyQueue(&Q);
- 作用:销毁队列。
- 含义:
- 释放队列
Q所占用的内存空间; - 使队列不再可用。
- 释放队列
8.2.2 入队和出队
入队
EnQueue(&Q, x);
- 若队列
Q未满,则将元素x加入队列。 - 加入后,
x成为新的队尾元素。
出队
DeQueue(&Q, &x);
- 若队列
Q非空,则删除队头元素。 - 被删除的队头元素用
x返回。
8.2.3 读队头和判空
读队头元素
GetHead(Q, &x);
- 若队列
Q非空,则将队头元素赋值给x。 - 只读不删。
判断队空
QueueEmpty(Q);
- 若队列
Q为空,则返回true。 - 否则返回
false。
8.2.4 操作分类总结
| 分类 | 操作 | 作用 |
|---|---|---|
| 创 | InitQueue(&Q) |
构造空队列 |
| 销 | DestroyQueue(&Q) |
销毁队列 |
| 增 | EnQueue(&Q, x) |
入队 |
| 删 | DeQueue(&Q, &x) |
出队 |
| 查 | GetHead(Q, &x) |
读队头元素 |
| 判定 | QueueEmpty(Q) |
判断队列是否为空 |
8.3 队列的顺序实现
8.3.1 队列的顺序存储
定义:#顺序队列
描述: 顺序队列是用顺序存储方式实现的队列,通常用数组保存队列元素,并用队头指针、队尾指针表示队列范围。
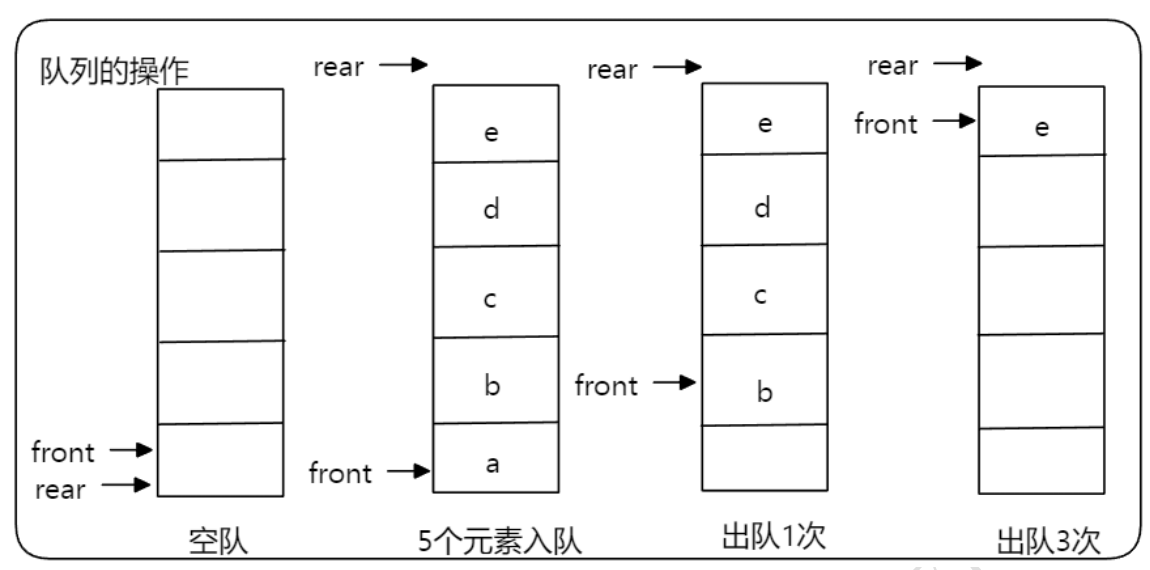
图示解读
front指向队头元素,rear指向队尾元素的下一个位置。- 入队先在
rear处写入,再令rear后移;出队先读取front处元素,再令front后移。 - 普通顺序队列会出现数组前部已经空闲、
rear却到达末端的“假溢出”,循环队列由此引出。
初始状态 $$ Q.front=Q.rear=0 $$
进队操作
- 队列不满时:
- 先把元素送入队尾位置;
- 再将队尾指针加 $1$。
出队操作
- 队列不空时:
- 先取出队头元素;
- 再将队头指针加 $1$。
8.3.2 代码定义
以下函数示例沿用原 PDF 的 C++ 引用形参 SqQueue &Q / LinkQueue &Q;ElemType 是待替换的元素类型。上面的 InitQueue(&Q) 等是抽象操作记号,下文实际 C++ 调用传入 Q。普通顺序/循环队列,以及带头结点/不带头结点的同名函数各是备选实现,不能原样全部拼在一起编译。
#define MaxSize 10

typedef struct {
    ElemType data[MaxSize];  // 用静态数组存放队列元素
    int front, rear;         // 队头指针和队尾指针
} SqQueue;
指针含义
front指向队头元素。rear指向队尾元素的下一个位置。rear指向的位置也是下一个新元素准备入队的位置。
8.3.3 初始化
void InitQueue(SqQueue &Q) {
    Q.front = 0;
    Q.rear = 0;
}
解释
- 初始时队列为空。
- 队头指针和队尾指针都指向 $0$。
8.3.4 判空
判空条件 $$ Q.rear==Q.front $$
代码
bool QueueEmpty(SqQueue Q) {
    if (Q.rear == Q.front)
        return true;
    else
        return false;
}
8.3.5 普通顺序队列入队
bool EnQueue(SqQueue &Q, ElemType x) {
    if (Q.rear == MaxSize)
        return false;

    Q.data[Q.rear] = x;
    Q.rear = Q.rear + 1;
    return true;
}
问题
- 普通顺序队列只让
rear向后移动。 - 出队后,数组前面的空间可能空出来。
- 如果不循环利用这些空间,会出现“假溢出”:
- 队列实际上还有空位;
- 但
rear已经到达数组末尾。
因此,顺序队列常采用循环队列实现。
8.4 循环队列
定义:#循环队列
描述: 循环队列是把顺序队列的数组空间看成首尾相接的环,使队头、队尾指针可以循环移动。
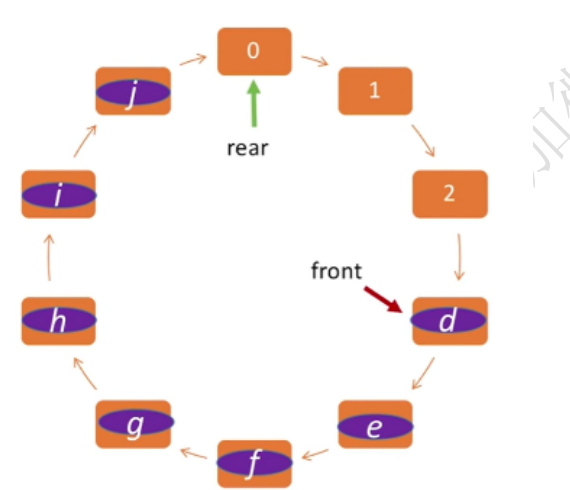
图示解读
- 环形只是下标按模运算循环,底层存储仍是一维数组。
front指向队头元素,rear指向下一次入队位置;二者都按(index+1)%MaxSize后移。- 本图采用“牺牲一个存储单元”的判满方案:队空为
front==rear,队满为(rear+1)%MaxSize==front。
8.4.1 核心操作
入队时队尾指针后移 $$ Q.rear=(Q.rear+1)\bmod MaxSize $$
出队时队头指针后移 $$ Q.front=(Q.front+1)\bmod MaxSize $$
队列长度 $$ (Q.rear+MaxSize-Q.front)\bmod MaxSize $$
队满条件:牺牲一个存储单元时 $$ (Q.rear+1)\bmod MaxSize==Q.front $$
队空条件 $$ Q.rear==Q.front $$
8.4.2 循环队列入队
基本语句
Q.data[Q.rear] = x;
Q.rear = (Q.rear + 1) % MaxSize;
完整代码
bool EnQueue(SqQueue &Q, ElemType x) {
    if ((Q.rear + 1) % MaxSize == Q.front)
        return false;

    Q.data[Q.rear] = x;
    Q.rear = (Q.rear + 1) % MaxSize;
    return true;
}
解释
- 先判断队满。
- 若队满,入队失败。
- 若未满,把
x放入rear指向的位置。 rear取模后移,体现循环。
注意
- 若采用“牺牲一个存储单元”的方式:
- 队空条件是
rear == front; - 队满条件是
(rear + 1) % MaxSize == front。
- 队空条件是
- 牺牲一个存储单元的目的是区分队空和队满。
8.4.3 循环队列出队
bool DeQueue(SqQueue &Q, ElemType &x) {
    if (Q.rear == Q.front)
        return false;

    x = Q.data[Q.front];
    Q.front = (Q.front + 1) % MaxSize;
    return true;
}
解释
- 先判断队空。
- 若队空,出队失败。
- 若非空,把队头元素赋给
x。 front取模后移。
8.4.4 获取队头元素
bool GetHead(SqQueue Q, ElemType &x) {
    if (Q.rear == Q.front)
        return false;

    x = Q.data[Q.front];
    return true;
}
区别
GetHead只读队头,不移动front。DeQueue读取后会移动front。
8.4.5 队列长度公式
循环队列的数据元素个数为: $$ (Q.rear+MaxSize-Q.front)\bmod MaxSize $$
为什么要加 MaxSize
- 当
rear已经绕回前面,而front在后面时,直接计算: $$ Q.rear-Q.front $$ 可能得到负数。 - 加上
MaxSize后再取模,可以保证结果落在合法范围内。
8.4.6 判空、判满的三种方法
方法一:牺牲一个存储单元
- 队空: $$ Q.front==Q.rear $$
- 队满: $$ (Q.rear+1)\bmod MaxSize==Q.front $$
- 实际最多存放: $$ MaxSize-1 $$ 个元素。
方法二:增加 size 变量
结构定义
const int MAXSIZE = 10;

typedef struct {
    ElemType data[MAXSIZE];
    int front, rear;
    int size;
} SqQueue;
判空和判满
- 队空: $$ Q.size==0 $$
- 队满: $$ Q.size==MAXSIZE $$
解释
- 每次成功入队,
size加 $1$。 - 每次成功出队,
size减 $1$。 - 该方法不需要牺牲一个数组单元。
方法三:增加 tag 标记
思想
- 当
front == rear时,队列可能为空,也可能为满。 - 用
tag记录最近一次成功操作:- 最近一次是出队,则
tag = 0; - 最近一次是入队,则
tag = 1。
- 最近一次是出队,则
- 初始化空队列时也应设置
tag = 0;只有成功入队或出队后才更新标记。
判定
- 当: $$ Q.front==Q.rear \quad \text{且} \quad Q.tag==0 $$ 队列为空。
- 当: $$ Q.front==Q.rear \quad \text{且} \quad Q.tag==1 $$ 队列为满。
8.5 队列的链式实现
8.5.1 链式队列定义
定义:#链式队列
描述: 链式队列是用链式存储方式实现的队列,通常同时保存队头指针和队尾指针。
基本概念
- 链头是队头。
- 队头用于出队。
- 队尾用于入队。
- 设置队尾指针可以让入队操作保持 $O(1)$。
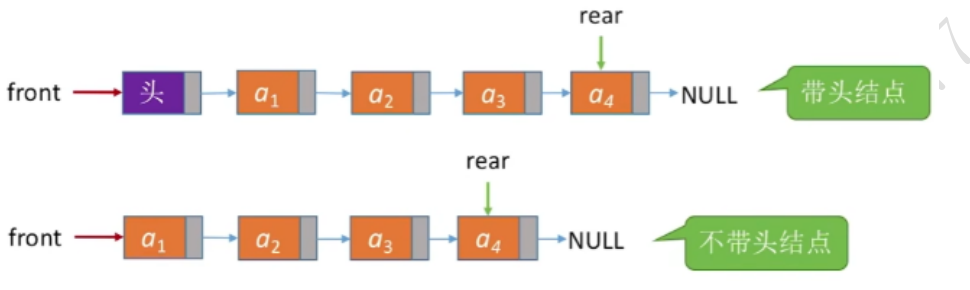
图示解读
- 带头结点时,
front始终指向头结点,rear指向最后一个数据结点;空队时二者都指向头结点。 - 不带头结点时,
front指向首元结点,rear指向尾结点;空队时二者都为NULL。 - 队尾指针使入队为 $O(1)$;出队从队头进行,也为 $O(1)$。
代码定义
typedef struct LinkNode {
    ElemType data;
    struct LinkNode *next;
} LinkNode;

typedef struct {
    LinkNode *front;
    LinkNode *rear;
} LinkQueue;
8.5.2 带头结点的初始化
void InitQueue(LinkQueue &Q) {
    Q.front = Q.rear = (LinkNode *)malloc(sizeof(LinkNode));
    Q.front->next = NULL;
}
解释
- 初始时,
front和rear都指向头结点。 - 头结点不存放有效数据。
- 第一个有效元素位于:
Q.front->next
判空
bool IsEmpty(LinkQueue Q) {
    if (Q.front == Q.rear)
        return true;
    else
        return false;
}
带头结点时,队空条件为: $$ Q.front==Q.rear $$
8.5.3 不带头结点的初始化
void InitQueue(LinkQueue &Q) {
    Q.front = NULL;
    Q.rear = NULL;
}
判空
bool IsEmpty(LinkQueue Q) {
    if (Q.front == NULL)
        return true;
    else
        return false;
}
不带头结点时,队空条件为: $$ Q.front==NULL $$
也可以写成: $$ Q.rear==NULL $$
8.5.4 入队:带头结点
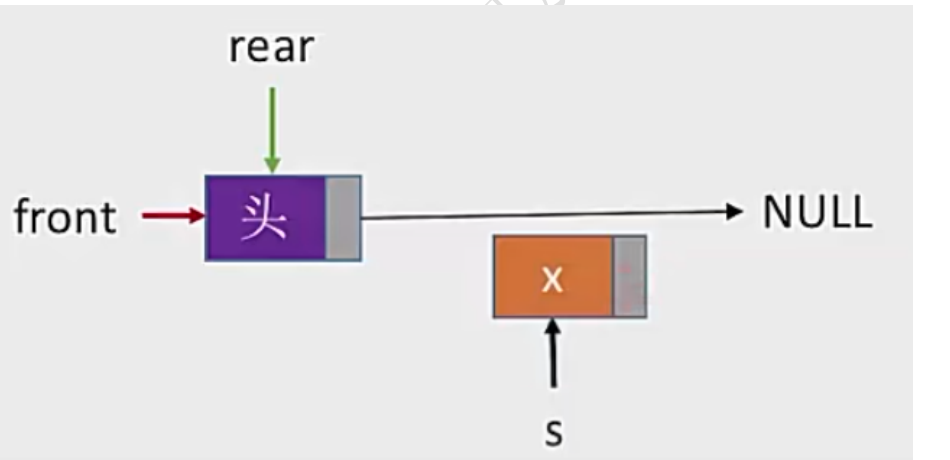
图示解读
- 先令新结点
s->next=NULL,再执行Q.rear->next=s把它接到原队尾之后。 - 最后执行
Q.rear=s更新队尾指针;两条语句的顺序不能颠倒。 - 即使原队列为空,头结点仍存在,因此上述连接方式无需另分支处理。
void EnQueue(LinkQueue &Q, ElemType x) {
    LinkNode *s = (LinkNode *)malloc(sizeof(LinkNode));
    s->data = x;
    s->next = NULL;

    Q.rear->next = s;
    Q.rear = s;
}
解释
- 新结点
s插入到rear所指结点之后。 - 再让
rear指向新结点。 - 带头结点时,空队列也可以直接执行这套逻辑。
8.5.5 入队:不带头结点
void EnQueue(LinkQueue &Q, ElemType x) {
    LinkNode *s = (LinkNode *)malloc(sizeof(LinkNode));
    s->data = x;
    s->next = NULL;

    if (Q.front == NULL) {
        Q.front = s;
        Q.rear = s;
    } else {
        Q.rear->next = s;
        Q.rear = s;
    }
}
解释
- 不带头结点时,必须单独处理空队列。
- 插入第一个元素时:
front指向该结点;rear也指向该结点。
- 插入非第一个元素时:
- 新结点接到
rear后面; - 再更新
rear。
- 新结点接到
8.5.6 出队:带头结点
空队列状态 $$ Q.front==Q.rear $$
代码
bool DeQueue(LinkQueue &Q, ElemType &x) {
    if (Q.front == Q.rear)
        return false;

    LinkNode *p = Q.front->next;
    x = p->data;
    Q.front->next = p->next;

    if (Q.rear == p)
        Q.rear = Q.front;

    free(p);
    return true;
}
解释
- 带头结点时,
front指向头结点,不指向当前队头元素。 - 当前队头元素是:
Q.front->next
- 若出队的是最后一个结点,则需要让:
Q.rear = Q.front;
- 否则
rear会指向已经释放的结点。
8.5.7 出队:不带头结点
空队列状态 $$ Q.front==NULL $$
或: $$ Q.rear==NULL $$
代码
bool DeQueue(LinkQueue &Q, ElemType &x) {
    if (Q.front == NULL)
        return false;

    LinkNode *p = Q.front;
    x = p->data;
    Q.front = p->next;

    if (Q.rear == p) {
        Q.front = NULL;
        Q.rear = NULL;
    }

    free(p);
    return true;
}
解释
- 不带头结点时,
front直接指向当前队头元素。 - 若本次出队的是最后一个结点,出队后队列为空。
- 此时必须同时让:
Q.front = NULL;
Q.rear = NULL;
8.5.8 链式队列和顺序队列对比
| 对比维度 | 顺序队列 | 链式队列 |
|---|---|---|
| 存储方式 | 顺序存储 | 链式存储 |
| 空间要求 | 需要连续空间 | 不要求连续空间 |
| 是否可能队满 | 可能队满 | 一般不考虑队满 |
| 入队复杂度 | $O(1)$ | $O(1)$ |
| 出队复杂度 | $O(1)$ | $O(1)$ |
| 额外空间 | 无指针域 | 每个结点有指针域 |
注意
- 链式存储一般不会出现“队满”问题。
- 顺序存储是静态数组实现时,可能出现存满的情况。
- 链式队列也不是无限容量,最终仍然受机器内存限制。
8.6 双端队列
定义:#双端队列
描述: 双端队列是允许从两端进行插入和删除的线性表。
8.6.1 三类双端队列
| 类型 | 插入限制 | 删除限制 |
|---|---|---|
| 双端队列 | 两端都可插入 | 两端都可删除 |
| 输入受限的双端队列 | 只允许一端插入 | 两端都可删除 |
| 输出受限的双端队列 | 两端都可插入 | 只允许一端删除 |
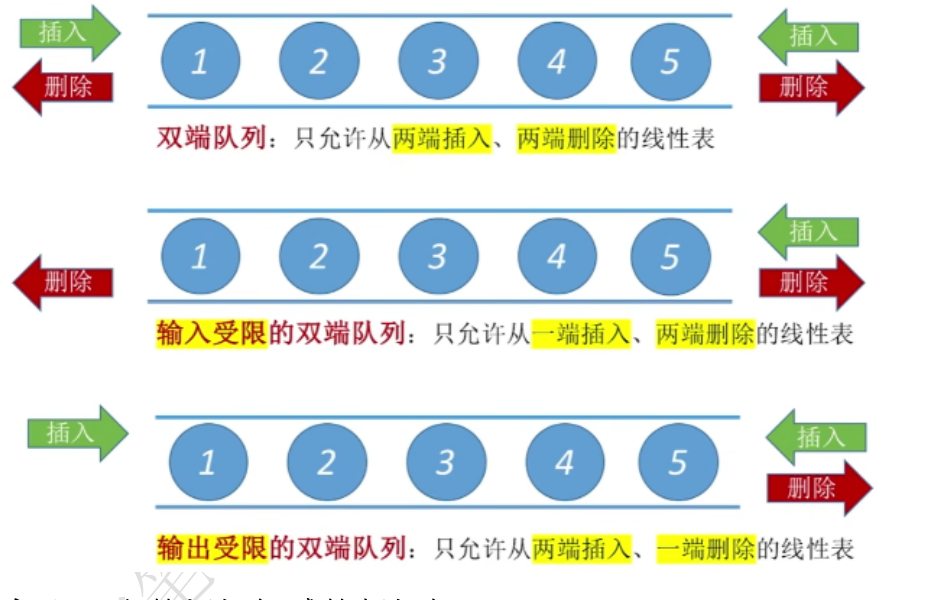
图示解读
- 普通双端队列:两端都允许插入和删除。
- 输入受限双端队列:只允许一端插入,但两端都能删除。
- 输出受限双端队列:两端都能插入,但只允许一端删除。
- 判断输出序列是否合法时,必须同时遵守输入顺序和受限端的操作约束,不能只看最终元素排列。
8.6.2 常见考点
题型:#双端队列输出序列
第一部分:解题方法
- 常见题目会给定输入序列,要求判断某个输出序列是否合法。
- 输入序列指元素进入队列的顺序。
- 输出序列指元素离开队列的顺序。
输入序列
- 例如输入序列为: $$ 1,2,3,4 $$
- 无论输出顺序如何,输入时都必须按: $$ 1\to 2\to 3\to 4 $$
输出序列
- 例如输出序列为: $$ 4,3,2,1 $$
- 无论何时输入,最终离开队列的顺序必须是: $$ 4\to 3\to 2\to 1 $$
第二部分:典型例题
例题:输入序列为 $1,2,3,4$ 时,输入受限的双端队列有哪些典型非法输出?
原 PDF 给出的非法输出序列为: $$ 4213 $$
和: $$ 4231 $$
理解
- 输入受限表示只能从一端插入。
- 虽然删除可以从两端进行,但插入顺序仍受到限制。
- 因此不是任意排列都能作为输出序列。
第三部分:知识点复盘
- 双端队列比普通队列灵活。
- 输入受限时,插入端被限制,删除端不限制。
- 输出受限时,删除端被限制,插入端不限制。
- 题目通常不是考概念背诵,而是考给定输入序列下的输出序列是否合法。
教材补充:队列的典型应用与边界
层次处理和图搜索
- 二叉树层次遍历把根入队;每次出队一个结点,并把其非空孩子从左到右入队。队列中的元素始终是“已经发现、尚未展开”的结点,详见二叉树层次遍历。
- 图的 BFS 在顶点首次发现并准备入队时就标记访问。若等到出队才标记,同一顶点可能被多个前驱重复入队,详见图的 BFS。
- 无权图中,普通 FIFO 队列保证顶点按距离层次非递减顺序展开,因此首次发现距离就是最少边数;DFS 栈不具备这一保证。
计算机系统中的排队
| 场景 | 队列中的对象 | 需要注意的规则 |
|---|---|---|
| 设备或打印请求 | 等待服务的请求 | 纯 FIFO 公平,但也可能按优先级或最短作业等策略重排 |
| 数据缓冲 | 已到达、尚未消费的数据 | 环形缓冲区常用 front/rear;满和空必须能区分 |
| 就绪进程 | 等待 CPU 的进程 | 先来先服务可用 FIFO;时间片轮转会把未完成进程重新放回队尾 |
| 消息或任务 | 待处理消息 | 多生产者、多消费者还需要同步互斥,这属于操作系统层面的额外约束 |
普通队列、双端队列与优先队列不能混淆
- 普通队列按到达先后出队,即 FIFO。
- 双端队列允许在一端或两端插入、删除,但具体合法序列由输入/输出受限规则决定。
- 优先队列按优先级选择下一个元素,不保证最早到达者先出;常用堆实现,见堆及其应用。
WARNING · 易错边界 “系统中出现等待队列”不代表调度策略一定是 FIFO。题目若给出优先级、时间片或最短任务规则,应按相应策略决定出队对象;数据结构中的普通队列只描述 FIFO 这一种规则。
相关知识
- 科目导航:数据结构导航
- 阅读顺序:上一篇:栈基本概念 · 下一篇:栈在括号匹配中的应用
- 关联专题:栈与队列代码
8.7 本节复盘
必须掌握
- 队列是只允许一端插入、另一端删除的线性表。
- 队列的规则是先进先出: $$ \text{FIFO} $$
- 顺序队列用数组、队头指针和队尾指针实现。
- 常见约定:
front指向队头元素;rear指向队尾元素的下一个位置。
- 循环队列入队: $$ Q.rear=(Q.rear+1)\bmod MaxSize $$
- 循环队列出队: $$ Q.front=(Q.front+1)\bmod MaxSize $$
- 循环队列长度: $$ (Q.rear+MaxSize-Q.front)\bmod MaxSize $$
- 牺牲一个单元时的队满条件: $$ (Q.rear+1)\bmod MaxSize==Q.front $$
- 链式队列通常需要同时维护队头指针和队尾指针。
- 双端队列可以从两端进行操作,输入受限和输出受限要分清。
易错点
EnQueue是入队,DeQueue是出队。DestroyQueue是销毁队列,不是删除队头元素。GetHead只读取队头元素,不删除。- 普通顺序队列容易出现假溢出,所以常用循环队列。
- 循环队列中
rear == front通常表示队空,但也可能和队满混淆,所以需要额外处理。 - 链式队列带头结点和不带头结点的空队条件不同。
- 带头结点链式队列删除最后一个结点时,要让
rear回到头结点。 - 不带头结点链式队列删除最后一个结点时,要让
front和rear都变为NULL。
一句话总结
- 队列:两端操作,先进先出。
- 循环队列:用取模解决数组循环利用。
- 链式队列:用
front和rear保证队头删除、队尾插入都是 $O(1)$。 - 双端队列:两端操作更灵活,考试常判断输出序列是否合法。