Lecture 7:栈基本概念
408 学习笔记:Lecture 7:栈基本概念。保留原有知识内容、公式与图示;有对应原件时提供查看和下载入口。
本页目录
7.1 栈的定义
定义:#栈
描述: 栈是只允许在一端进行插入或删除操作的线性表。
解释
- 栈本质上仍然是线性表。
- 栈的限制在于:
- 只能在一端插入;
- 只能在同一端删除。
- 允许插入和删除的一端称为栈顶: $$ \text{Top} $$
- 另一端称为栈底: $$ \text{Bottom} $$
- 不含任何元素的栈称为空栈。
逻辑特点
- 后进入栈的元素先离开栈。
- 先进入栈的元素后离开栈。
- 因此栈又称为后进先出表: $$ \text{LIFO}=\text{Last In First Out} $$
图示信息结构化
- 栈底是最早进入且最后离开的元素所在端,位置通常固定。
- 栈顶是唯一允许插入、删除的一端,随入栈和出栈移动。
- 空栈没有栈顶元素;顺序栈采用
top=-1时,top表示当前栈顶元素的数组下标。
7.2 栈的基本操作
7.2.1 初始化和销毁
初始化
InitStack(&S);
- 作用:初始化栈。
- 含义:
- 构造一个空栈
S; - 分配必要的存储空间;
- 设置初始状态。
- 构造一个空栈
销毁
DestroyStack(&S);
- 作用:销毁栈。
- 含义:
- 释放栈
S占用的存储空间; - 使栈不再可用。
- 释放栈
7.2.2 入栈和出栈
入栈
Push(&S, x);
- 又称进栈、压栈。
- 若栈
S未满,则将元素x加入栈中。 - 加入后,
x成为新的栈顶元素。
出栈
Pop(&S, &x);
- 又称弹栈。
- 若栈
S非空,则弹出栈顶元素。 - 被弹出的元素用
x返回。
7.2.3 读栈顶和判空
读栈顶元素
GetTop(S, &x);
- 若栈
S非空,则用x返回栈顶元素。 - 该操作只读取,不删除栈顶元素。
判断栈空
StackEmpty(S);
- 若栈
S为空,则返回true。 - 否则返回
false。
7.2.4 操作分类总结
| 分类 | 操作 | 作用 |
|---|---|---|
| 创 | InitStack(&S) |
构造空栈 |
| 消 | DestroyStack(&S) |
销毁栈 |
| 增 | Push(&S, x) |
入栈 |
| 删 | Pop(&S, &x) |
出栈 |
| 查 | GetTop(S, &x) |
读栈顶元素 |
| 判定 | StackEmpty(S) |
判断栈是否为空 |
7.3 卡特兰数
题型:#进栈出栈序列
第一部分:解题方法
有 $n$ 个不同元素按照固定顺序依次进栈,能够得到的合法出栈序列个数为: $$ \frac{1}{n+1}C_{2n}^{n} $$
也可以写成组合数形式: $$ \frac{1}{n+1}\binom{2n}{n} $$
该公式称为卡特兰数: $$ C_n=\frac{1}{n+1}\binom{2n}{n} $$
使用条件
- 入栈顺序已经固定。
- 每个元素都必须入栈一次、出栈一次。
- 出栈过程中不能违反栈的后进先出规则。
第二部分:典型例题
例题:3 个不同元素按 $1,2,3$ 的顺序入栈,合法出栈序列有多少种?
代入公式: $$ \frac{1}{3+1}\binom{2\times 3}{3} =\frac{1}{4}\binom{6}{3} =\frac{1}{4}\times 20 =5 $$
所以共有 $5$ 种合法出栈序列。
第三部分:知识点复盘
- 卡特兰数不是任意排列数。
- 全排列数量是: $$ n! $$
- 合法出栈序列数量通常小于 $n!$。
- 判断某个序列是否合法时,要模拟入栈、出栈过程。
7.4 栈的顺序存储实现
7.4.1 顺序栈定义
定义:#顺序栈
描述: 顺序栈是用顺序存储方式实现的栈,通常用静态数组保存栈中元素,并用栈顶指针记录栈顶位置。
特点
- 和顺序表类似,都用数组保存元素。
- 由于栈只允许在栈顶操作,所以只需要重点维护栈顶指针。
- 常见约定:
top指向当前栈顶元素;- 空栈时
top == -1; - 栈满时
top == MaxSize - 1。
以下 ElemType 是待替换的元素类型;函数形参 SqStack &S、ElemType &x 使用 C++ 引用,并非 C 语言函数形参。原 PDF 的示例整体按 C++ 语法阅读,前面的 InitStack(&S) 等是抽象操作记号,不要与下文具体调用 InitStack(S) 混作同一套函数签名。
代码定义
#define MaxSize 10

typedef struct {
    ElemType data[MaxSize];  // 静态数组存放栈中元素
    int top;                 // 栈顶指针
} SqStack;                   // Sq: sequence,表示顺序存储
7.4.2 初始化
代码
void InitStack(SqStack &S) {
    S.top = -1;
}
使用示例
void testStack() {
    SqStack S;       // 声明一个顺序栈,系统分配空间
    InitStack(S);    // 初始化栈

    // 后续操作

    // 函数运行结束后,系统自动回收局部变量空间
}
解释
top = -1表示当前没有栈顶元素。- 因为数组下标从 $0$ 开始,所以 $-1$ 可以表示“无有效元素”。
- 若用静态数组作为局部变量,函数结束后系统会自动回收空间。
7.4.3 判断栈空
逻辑
- 最开始栈中无元素时: $$ S.top=-1 $$
- 因此判断栈空的条件为: $$ S.top==-1 $$
代码
bool StackEmpty(SqStack S) {
    if (S.top == -1)
        return true;
    else
        return false;
}
补充:另一种栈顶指针约定
- 如果把初始值设置为: $$ S.top=0 $$
- 通常表示
top指向下一个可插入位置,而不是当前栈顶元素。 - 此时第一个元素入栈后,
top会移动到data[1]的位置。 - 对应的栈满条件变为: $$ S.top==MaxSize $$
- 注意:两种约定不能混用,代码中的入栈、出栈、判空、判满条件必须保持一致。
7.4.4 入栈
逻辑
- 入栈前必须先判断栈是否已满。
- 若未满:
- 栈顶指针先加 $1$;
- 再把新元素写入新的栈顶位置。
代码
bool Push(SqStack &S, ElemType x) {
    if (S.top == MaxSize - 1)
        return false;

    S.top = S.top + 1;
    S.data[S.top] = x;
    return true;
}
等价写法
S.data[++S.top] = x;
易错点
++S.top表示先让top加 $1$,再访问数组。- 不能写成:
S.data[S.top++] = x;
- 因为在
top == -1的空栈约定下,后者会先访问data[-1],下标非法。
7.4.5 出栈
逻辑
- 出栈前必须先判断栈是否为空。
- 若非空:
- 先取出当前栈顶元素;
- 再让栈顶指针减 $1$。
代码
bool Pop(SqStack &S, ElemType &x) {
    if (S.top == -1)
        return false;

    x = S.data[S.top];
    S.top = S.top - 1;
    return true;
}
注意
- 出栈以后,原数组位置中的数据仍可能留在内存中。
- 该元素只是逻辑上被删除。
- 顺序栈的出栈操作没有
free。
7.4.6 读取栈顶元素
逻辑
- 读取栈顶前必须先判断栈是否为空。
- 读取栈顶元素不会改变
top。 - 因此
GetTop与Pop的区别是:GetTop只读不删;Pop既读又删。
代码
bool GetTop(SqStack S, ElemType &x) {
    if (S.top == -1)
        return false;

    x = S.data[S.top];
    return true;
}
7.4.7 顺序栈操作复杂度
| 操作 | 条件判断 | 是否移动大量元素 | 时间复杂度 |
|---|---|---|---|
| 判空 | S.top == -1 |
否 | $O(1)$ |
| 判满 | S.top == MaxSize - 1 |
否 | $O(1)$ |
| 入栈 | 先判满 | 否 | $O(1)$ |
| 出栈 | 先判空 | 否 | $O(1)$ |
| 读栈顶 | 先判空 | 否 | $O(1)$ |
7.5 共享栈
定义:#共享栈
描述: 共享栈是在同一片数组空间中实现两个栈,使两个栈从数组两端向中间增长。
基本思想
- 0 号栈从数组左端开始增长。
- 1 号栈从数组右端开始增长。
- 两个栈共享同一片数组空间。
- 当两个栈顶相邻时,说明没有剩余空间。
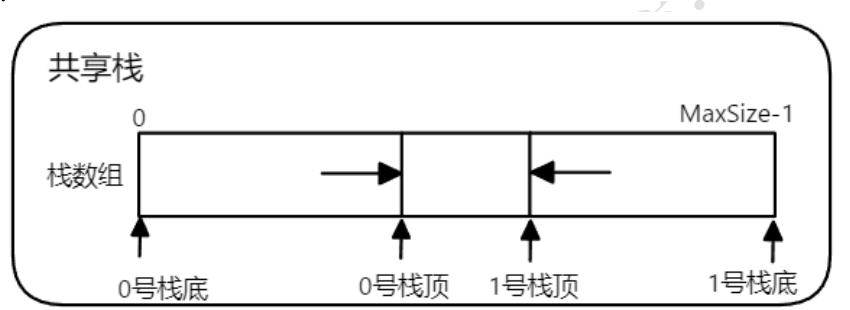
图示解读
- 0 号栈从下标 $0$ 向右增长,1 号栈从下标 $MaxSize-1$ 向左增长。
- 初始时
top0=-1、top1=MaxSize;栈满条件为top0+1==top1。 - 两个栈共用尚未占用的中间区域,能减少两个普通顺序栈一边溢出、另一边仍有空位的浪费。
代码定义
#define MaxSize 10

typedef struct {
    ElemType data[MaxSize];  // 静态数组存放两个栈的元素
    int top0;                // 0 号栈栈顶指针
    int top1;                // 1 号栈栈顶指针
} ShStack;
初始化
void InitStack(ShStack &S) {
    S.top0 = -1;
    S.top1 = MaxSize;
}
栈满条件
- 0 号栈栈顶的右边紧挨着 1 号栈栈顶时,两个栈之间没有空闲单元。
- 因此共享栈的栈满条件为: $$ S.top0+1==S.top1 $$
特点
- 实现了两个栈。
- 两个栈共享同一个存储空间。
- 当一个栈元素较多、另一个栈元素较少时,可以更充分地利用数组空间。
- 适合两个栈空间需求此消彼长的场景。
7.6 栈的链式存储实现
定义:#链栈
描述: 链栈是用链式存储方式实现的栈,本质上是操作受限的单链表。
概念
- 链栈和单链表的定义几乎没有区别。
- 区别主要是名词和操作限制:
- 单链表可以在多个位置插入、删除;
- 链栈只在栈顶插入、删除。
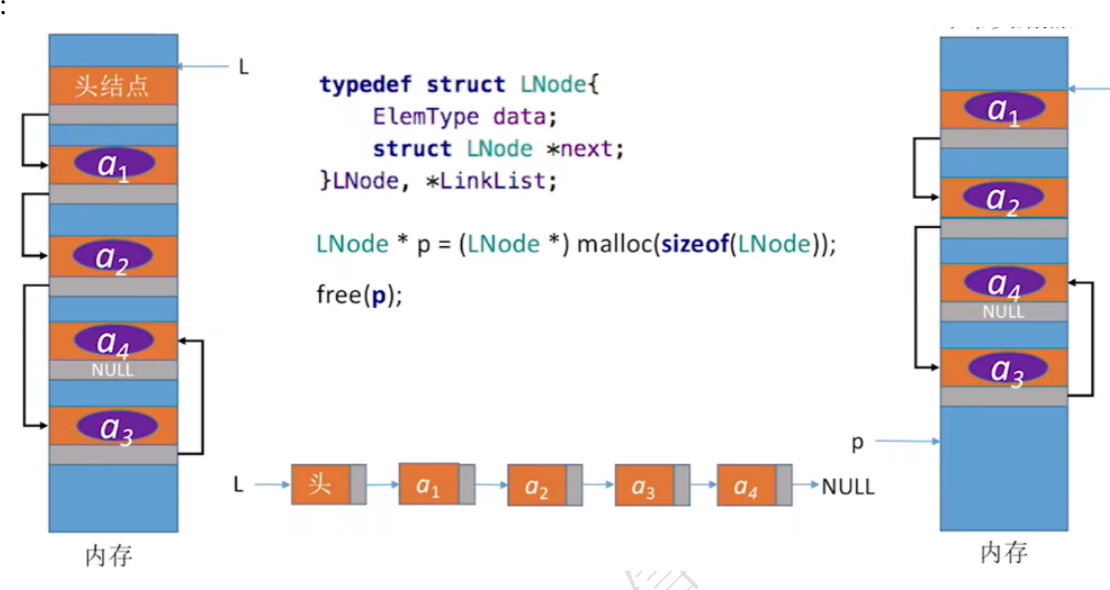
图示解读
- 链栈结点在物理内存中不必连续,逻辑次序由
next指针连接。 - 栈顶指针指向链表首元结点;入栈和出栈都在表头完成,时间复杂度均为 $O(1)$。
- 采用带头结点还是不带头结点会影响空栈判定和具体代码,但不会改变后进先出的逻辑。
代码定义
typedef struct Linknode {
    ElemType data;
    struct Linknode *next;
} *LiStack;
解释
data是数据域。next是指针域。LiStack可以理解为链栈的栈顶指针。- 链栈通常把链表头部作为栈顶,便于在 $O(1)$ 时间内入栈、出栈。
补充写法 在一些教材中,也会把结点类型和指针类型分开写:
typedef struct Linknode {
    ElemType data;
    struct Linknode *next;
} Linknode, *LiStack;
7.6.1 链栈与顺序栈对比
| 对比维度 | 顺序栈 | 链栈 |
|---|---|---|
| 存储方式 | 顺序存储 | 链式存储 |
| 存储空间 | 需要连续空间 | 不要求连续空间 |
| 容量限制 | 受 MaxSize 限制 |
理论上只受内存限制 |
| 栈满判断 | 需要 | 通常不需要固定容量判满 |
| 指针开销 | 无额外指针域 | 每个结点有指针域 |
| 入栈出栈 | $O(1)$ | $O(1)$ |
7.7 面试题:栈和队列的区别
7.7.1 队列
定义:#队列
描述: 队列是允许在一端进行插入、另一端进行删除的线性表。
特点
- 队列像排队一样。
- 进入队列的元素按先进先出的规则处理: $$ \text{FIFO}=\text{First In First Out} $$
- 通常在表尾插入。
- 通常在表头删除。
- 因为队列经常插入、删除,常用定长数组实现循环队列。
- 操作前需要判断队列是否为空、是否已满。
- 如果想要动态长度,也可以用链表存储队列。
- 链式队列需要记录:
- 队头指针;
- 队尾指针。
7.7.2 栈
特点
- 栈只能在固定的栈顶一端进行插入和删除;顺序栈常把数组有效区末端作为栈顶,而链栈常把链表表头作为栈顶,因此“栈顶”不能无条件等同于某种实现的物理表尾。
- 入栈、出栈都发生在栈顶。
- 栈按后进先出规则处理元素: $$ \text{LIFO}=\text{Last In First Out} $$
- 栈常用定长数组实现。
- 若用数组实现,可以用一个变量记录当前栈大小或栈顶位置。
7.7.3 对比表
| 对比维度 | 栈 | 队列 |
|---|---|---|
| 插入位置 | 栈顶 | 队尾 |
| 删除位置 | 栈顶 | 队头 |
| 操作端数 | 同一端插入、删除 | 一端插入、另一端删除 |
| 逻辑规则 | 后进先出 | 先进先出 |
| 英文缩写 | LIFO | FIFO |
| 常见顺序实现 | 顺序栈 | 循环队列 |
| 常见链式实现 | 链栈 | 链式队列 |
7.8 面试题:如何区分循环队列队空和队满
这一部分出现在原 PDF 的 Lecture 7 末尾,但主要属于后续队列内容。这里先按原 PDF 保留,正式讲队列时再展开。
7.8.1 普通情况下的问题
- 循环队列中,队空和队满有时会出现相同的判断形式: $$ Q.front==Q.rear $$
- 若不额外处理,就无法只靠这个条件区分队空和队满。
指针含义
- 队头指针
front指向第一个队列元素。 - 队尾指针
rear指向最后一个元素的下一个位置。 rear指向的位置也就是即将入队的位置。
7.8.2 方法一:牺牲一个存储单元
- 让循环队列永远空出一个位置。
- 当队尾指针再向后移动一格就会到达队头指针时,认为队列已满。
- 队满条件为: $$ (Q.rear+1)\bmod MaxSize==Q.front $$
- 队空条件仍为: $$ Q.front==Q.rear $$
7.8.3 方法二:增加元素个数变量
- 在队列类型中增设一个表示元素个数的数据成员:
int size;
- 队空条件为: $$ Q.size==0 $$
- 队满条件为: $$ Q.size==MaxSize $$
相关知识
- 科目导航:数据结构导航
- 阅读顺序:上一篇:顺序表和链表对比 · 下一篇:队列基本概念
- 关联专题:栈与队列代码
7.9 本节复盘
必须掌握
- 栈是只允许在一端插入或删除的线性表。
- 栈顶是允许操作的一端,栈底是另一端。
- 栈的逻辑规则是后进先出: $$ \text{LIFO} $$
- 顺序栈通常用数组和栈顶指针实现。
- 常见空栈条件: $$ S.top==-1 $$
- 常见栈满条件: $$ S.top==MaxSize-1 $$
- 共享栈的栈满条件: $$ S.top0+1==S.top1 $$
- $n$ 个不同元素按固定顺序入栈时,合法出栈序列个数为: $$ \frac{1}{n+1}\binom{2n}{n} $$
易错点
- 栈只能在栈顶插入、删除,不是任意位置都能操作。
GetTop只读取栈顶元素,不删除元素。Pop会改变栈顶指针。- 顺序栈出栈后,数组中的旧值可能还在,但逻辑上已经被删除。
S.data[++S.top]=x中的++不能随意写反。- 链栈不是新的逻辑结构,它仍然是栈,只是存储方式变成链式。
- 循环队列中
Q.front==Q.rear可能表示队空,也可能在未经处理时与队满混淆。
一句话总结
- 栈:只在一端操作,后进先出。
- 顺序栈:数组加栈顶指针。
- 共享栈:两个栈从数组两端向中间增长。
- 链栈:用单链表思想实现栈顶插入和删除。