Lecture 35:排序算法总结
408 学习笔记:Lecture 35:排序算法总结。保留原有知识内容、公式与图示;有对应原件时提供查看和下载入口。
本页目录
排序综合题不能只背一张表。先从“每趟做什么”辨认算法,再用时间、空间、稳定性、适用存储结构和输入特征逐项验证;所有复杂度结论都带有实现与输入前提。
35.1 内部排序算法总表
下表按常见统考实现给出紧确量级。$n$ 为记录数,$d$ 为关键字位数,$r$ 为每位可能取值数,$k$ 为计数排序的关键字取值范围大小。
| 算法 | 最好时间 | 平均时间 | 最坏时间 | 辅助空间 | 稳定性 | 核心特点 |
|---|---|---|---|---|---|---|
| 直接插入 | $\Theta(n)$ | $\Theta(n^2)$ | $\Theta(n^2)$ | $O(1)$ | 稳定 | 前缀有序,适合小规模或近乎有序 |
| 折半插入 | $\Theta(n\log n)$ | $\Theta(n^2)$ | $\Theta(n^2)$ | $O(1)$ | 稳定 | 只减少定位比较,不能消除批量移动 |
| 希尔 | 依增量序列而定 | 依增量序列而定 | 常见折半增量为 $O(n^2)$ | $O(1)$ | 不稳定 | 对多个增量子表做插入排序 |
| 冒泡(带标志) | $\Theta(n)$ | $\Theta(n^2)$ | $\Theta(n^2)$ | $O(1)$ | 稳定 | 相邻交换,可检测已有序后提前结束 |
| 快速 | $\Theta(n\log n)$ | $\Theta(n\log n)$ | $\Theta(n^2)$ | 平均 $O(\log n)$,最坏 $O(n)$ | 不稳定 | 划分递归,枢轴质量决定性能 |
| 简单选择 | $\Theta(n^2)$ | $\Theta(n^2)$ | $\Theta(n^2)$ | $O(1)$ | 不稳定 | 比较次数固定,交换次数少 |
| 堆排序 | $\Theta(n\log n)$ | $\Theta(n\log n)$ | $\Theta(n\log n)$ | $O(1)$ | 不稳定 | 线性建堆,反复输出堆顶 |
| 二路归并 | $\Theta(n\log n)$ | $\Theta(n\log n)$ | $\Theta(n\log n)$ | $O(n)$ | 稳定 | 每层线性归并,时间不随初始有序度明显改善 |
| LSD 基数 | $\Theta(d(n+r))$ | $\Theta(d(n+r))$ | $\Theta(d(n+r))$ | 常见为 $O(r)$ 或 $O(n+r)$ | 稳定 | 非比较排序,依赖关键字可分解为 $d$ 位 |
| 计数排序 | $\Theta(n+k)$ | $\Theta(n+k)$ | $\Theta(n+k)$ | 稳定实现为 $O(n+k)$ | 稳定实现可稳定 | 非比较排序,要求整数键的有限值域可承受 |
读表注意:
- 折半插入在每趟都做折半定位,因此最好情况下比较总量仍为 $\Theta(n\log n)$;平均和最坏情况下,$\Theta(n^2)$ 的记录移动占主导。
- 快排只有在划分较均衡时递归深度才为 $\Theta(\log n)$;连续产生规模为 $0$ 与 $n-1$ 的子问题时,时间和栈深分别退化为 $\Theta(n^2)$ 与 $\Theta(n)$。
- 希尔排序的时间复杂度必须结合增量序列说明,不能把某一增量序列的结论推广到所有实现。
- 基数排序若只保存各桶首尾指针并复用记录链域,附加队列信息可为 $O(r)$;若另开桶存储全部记录,则为 $O(n+r)$。
- 标准自底向上建堆是 $\Theta(n)$,但完整堆排序还要做 $n-1$ 次删除堆顶和调整,因此总时间仍为 $\Theta(n\log n)$。
- 计数排序的 $k$ 是最大键与最小键之差加 $1$;当 $k$ 远大于 $n$ 时,时间和空间都会浪费,不能只看它对 $n$ 的线性项。
35.1.1 比较排序的下界
- 对 $n$ 个互异关键字,基于比较的排序必须区分 $n!$ 种排列;二叉判定树高度至少为:
$$ \left\lceil\log_2(n!)\right\rceil=\Omega(n\log n) $$
- 因此任何比较排序的最坏比较次数都不可能优于 $\Omega(n\log n)$;在等概率排列等常见模型下,平均比较次数也有同阶下界。
- 基数排序不是比较排序,不受该判定树下界直接约束,但它受关键字结构、位数 $d$、基数 $r$ 和额外空间限制。
35.2 存储结构与稳定性
35.2.1 存储结构的适配
| 场景 | 更合适的算法 | 原因与边界 |
|---|---|---|
| 顺序表、要求原地 | 直接插入、希尔、冒泡、简单选择、堆 | 可直接按下标访问;堆与希尔尤其依赖高效随机定位 |
| 顺序表、追求平均速度 | 快速排序 | 连续区间划分方便,但要防止枢轴导致退化 |
| 链表、要求稳定且 $O(n\log n)$ | 归并排序 | 可通过改链合并,不要求随机访问;自底向上的链式实现可只用 $O(1)$ 个额外结点指针 |
| 链表、小规模或近乎有序 | 直接插入排序 | 找到位置后改链即可,移动记录代价小 |
| 固定位数的整数或字符串关键字 | 基数排序 | 链式桶分配与收集自然,但必须保持每趟稳定 |
- 折半查找虽然只需 $O(\log n)$ 次比较,但链表不能 $O(1)$ 访问中点,因此折半插入在链表上通常失去优势。
- 希尔排序与数组堆排序依赖下标间隔或父子下标关系,通常不用于普通链表。
- “某算法能否改写到某存储结构”与“是否适合”不是一回事;快排、冒泡、选择等也能设计链式版本,但不一定保留顺序表实现的常数优势。
35.2.2 稳定性结论与成立条件
- 稳定:直接插入、折半插入、冒泡、归并、基数。
- 不稳定:希尔、快速、简单选择、堆。
- 稳定性是具体算法实现的性质,而不是排序结果的性质:
- 插入排序应把新记录放在已有相等记录之后;
- 冒泡排序只交换严格逆序的相邻记录;
- 归并时关键字相等应先取左段记录;
- 基数排序每一趟的分配与收集都必须稳定。
- 源 PDF 中“选择插入排序”不是规范算法名,此处按其实际内容更正为简单选择排序。
题型:#稳定性判断
- 给相等关键字加标签,例如
3a, 3b,并令3a原先在前。 - 按算法的真实交换、移动或收集规则走一遍。
- 若存在某个合法输入能使
3b越过3a,该算法即不稳定;只看比较条件是否含等号并不足够。 - 远距离交换或跨组移动是高风险信号,所以希尔、快速、简单选择和堆排序通常不稳定。
35.3 排序过程辨识
35.3.1 直接插入与折半插入
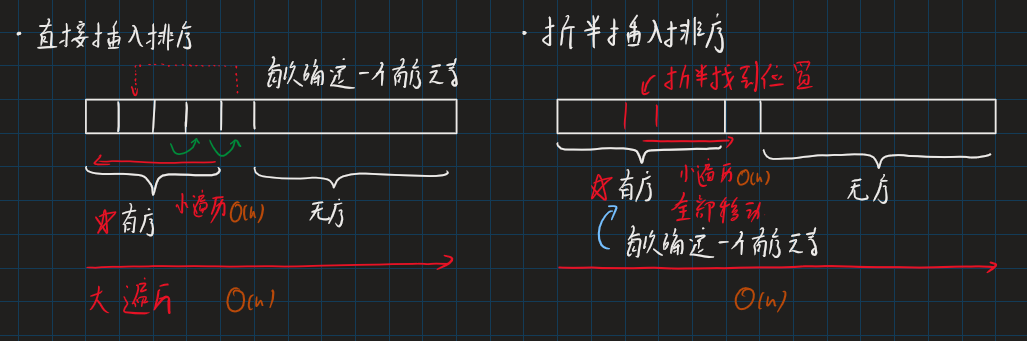
- 两者都维护有序前缀,并把当前记录插入其中;区别只在于如何寻找插入位置。
- 直接插入从后向前顺序比较;折半插入用二分查找位置,但定位后仍要整体后移后缀。
- 折半插入必须统一相等关键字的边界策略;插到已有相等记录之后时可保持稳定。
35.3.2 插入排序与简单选择排序
| 维度 | 直接插入排序 | 简单选择排序 |
|---|---|---|
| 已排序区 | 前缀有序,长度每趟加一 | 前缀已放好当前最小值 |
| 本趟扫描对象 | 向前扫描已排序区找插入位置 | 向后扫描未排序区找最小值 |
| 主要移动 | 多个较大元素整体后移 | 扫描结束后通常做一次交换 |
| 比较次数 | 随初始有序度变化 | 固定为 $n(n-1)/2$ |
| 稳定性 | 稳定 | 不稳定 |
- “暂存未排序区首元素,再向前移动较大元素”是插入排序。
- “扫描整个未排序区记住最小下标,最后与边界交换”是简单选择排序。
- 记录本身很大且交换代价高时,简单选择的交换次数至多 $n-1$,但它的比较次数仍为 $\Theta(n^2)$。
35.3.3 希尔与冒泡
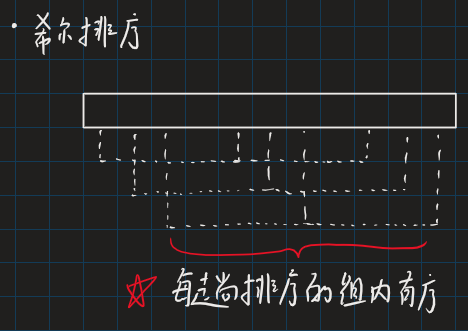
希尔排序按增量 $h$ 把间隔为 $h$ 的元素看作同一子表,各子表分别做直接插入;最终必须取 $h=1$。
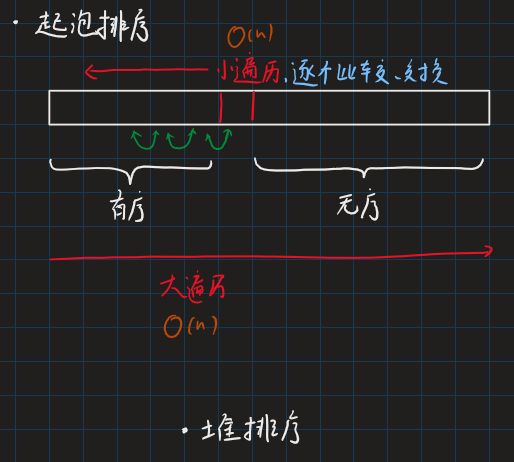
冒泡排序每趟扫描当前无序区,通过相邻交换把一个极值送到边界。带交换标志时,已有序输入只需一趟,时间为 $\Theta(n)$。
35.3.4 快速、堆与归并
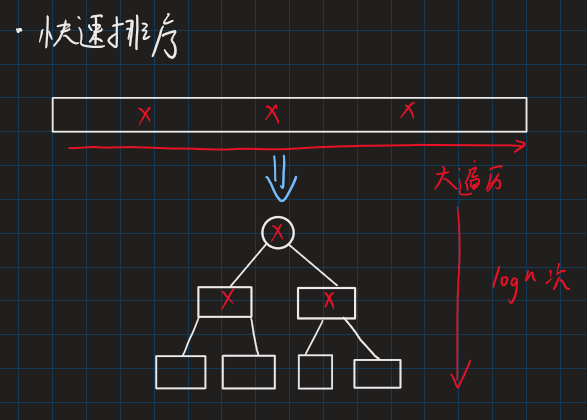
快排每次划分使枢轴到达最终位置。图中的 $\log n$ 层只对应较均衡划分;极端不平衡时递归深度可达 $n$。
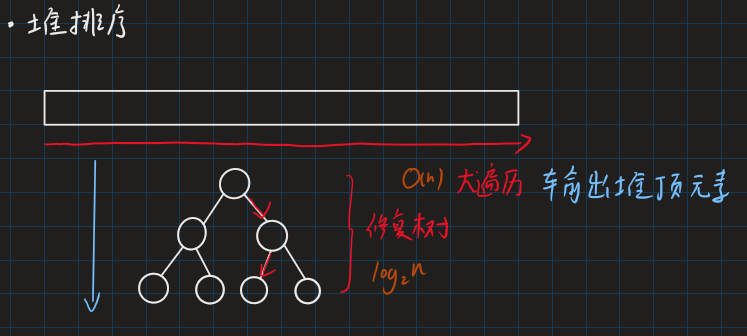
堆只保证父结点不小于(或不大于)孩子,并非全局有序。建堆为 $\Theta(n)$;每次交换堆顶后下坠为 $O(\log n)$,完整排序为 $\Theta(n\log n)$。
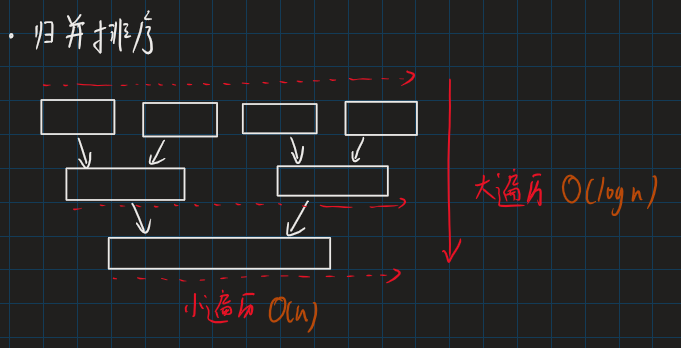
二路归并共有 $\Theta(\log n)$ 层,每层处理全部 $n$ 个元素,故总时间为 $\Theta(n\log n)$;数组实现通常需要 $O(n)$ 辅助空间。
35.3.5 一眼识别特征
| 现象 | 对应算法 |
|---|---|
| 相邻逆序即交换,某极值逐趟移动到边界 | 冒泡排序 |
| 选枢轴,左右指针划分,枢轴到最终位置 | 快速排序 |
| 下标满足 $i,2i,2i+1$ 或 $i,2i+1,2i+2$,不断上升或下坠 | 堆/堆排序 |
| 两个有序段用三个指针合为一个有序段 | 归并排序 |
| 按个位、十位等依次进入多个队列再收集 | 基数排序 |
| 多个增量子表分别插入排序,增量最终为 $1$ | 希尔排序 |
35.4 选型与高频陷阱
| 需求或数据特征 | 优先考虑 | 说明 |
|---|---|---|
| $n$ 小或基本有序 | 直接插入 | 简单、稳定、最好 $\Theta(n)$ |
| 平均速度快且可接受不稳定 | 快速排序 | 实践常用;应随机化或改进枢轴选择降低退化概率 |
| 最坏时间必须为 $\Theta(n\log n)$ 且额外空间小 | 堆排序 | 原地但不稳定,局部访问性通常不如快排 |
| 稳定且最坏 $\Theta(n\log n)$ | 归并排序 | 数组需 $O(n)$ 辅助空间,链表尤其合适 |
| 记录交换代价远高于比较 | 简单选择 | 交换少,但比较仍是 $\Theta(n^2)$ |
| 固定位数、取值范围可分桶 | 基数排序 | 可突破比较排序下界,但依赖关键字结构 |
| 外存文件远大于内存 | 多路归并 | 先生成初始归并段,再优化归并路数、段数与归并树 |
高频陷阱:
- 折半插入减少比较,不会把最坏记录移动量降到 $O(n\log n)$。
- 简单选择的比较次数与初始有序度无关;冒泡和直接插入则具有一定自适应性。
- 快排“枢轴最终就位”不代表左右子区间已经有序。
- 堆序只约束父子,不能由大根堆直接推出任意兄弟或跨子树结点的大小关系。
- 归并一个长度为 $n_1$ 与 $n_2$ 的有序段,最多比较 $n_1+n_2-1$ 次,而不是“每个元素最多比较一次”。
- 稳定算法若实现时错误处理相等关键字,也可能失去稳定性。
教材补充:计数排序
NOTE · 教材范围 计数排序不是 2027 年 408 考纲单列的必考算法,但 2027 版常用复习教材把它列为扩展内容。这里补齐算法原理、稳定实现和适用边界,不把它混入原 PDF 内容。
基本思想
若每条记录的整数关键字都落在闭区间 $[L,U]$,令:
$$ k=U-L+1 $$
用 count[x-L] 统计关键字 $x$ 出现次数。仅输出数值时,按关键字从小到大重复输出即可;若记录还带有其他字段且要求稳定性,则需要把计数改成前缀和,再把记录放到独立输出数组。
稳定实现
#include <stdlib.h>
typedef struct { int key; int payload; } Record; // payload 代表随关键字移动的其他字段

// n >= 0,L <= U,k = U-L+1 可由 int 表示;A、B 是互不重叠的 n 元素数组
// Record.key 必须落在 [L, U];返回 1 表示成功,0 表示内存分配失败
int CountingSort(Record A[], Record B[], int n, int L, int U) {
    int k = U - L + 1;
    int *count = calloc((size_t)k, sizeof *count);
    if (count == NULL) return 0;

    for (int i = 0; i < n; ++i)
        ++count[A[i].key - L];

    for (int i = 1; i < k; ++i)
        count[i] += count[i - 1];

    for (int i = n - 1; i >= 0; --i) {
        int p = A[i].key - L;
        B[--count[p]] = A[i];
    }

    free(count);
    return 1;
}
- 前缀和
count[p]表示关键字不大于该键的记录数,也就是该键在输出数组中的右边界后一位。 - 必须从右向左扫描输入,并在放置前递减计数,才能让原序列中靠右的相等记录落在输出中靠右,从而保持相对次序。
- 负关键字并不妨碍计数排序,只需统一减去下界 $L$ 作为数组偏移。
复杂度与适用边界
$$ \text{时间}=\Theta(n+k),\qquad \text{额外空间}=\Theta(n+k) $$
- 若只排序裸整数并直接重复输出,可不设长度为 $n$ 的输出数组,但这种简化不能表达带附属数据记录的稳定性。
- 计数排序不进行关键字之间的比较,因此不受比较排序 $\Omega(n\log n)$ 下界约束。
- 它只适合能映射到不太大的离散整数区间的关键字。对浮点数、任意字符串或极稀疏的巨大整数范围,直接开计数数组通常不合适。
- 基数排序可在每一位内部使用稳定的计数排序;若某一趟不稳定,前面各趟建立的低位次序会被破坏。
相关知识
- 科目导航:数据结构导航
- 阅读顺序:上一篇:外部排序 · 下一篇:重点算法汇总
- 关联专题:排序代码
35.5 本节复盘
- 先识别每趟动作,再核验复杂度、空间、稳定性和存储结构,比死记表格可靠。
- 比较排序最坏比较次数有 $\Omega(n\log n)$ 下界;基数排序依靠关键字分位绕开比较模型。
- 插入看“扫描已排序区找位置”,选择看“扫描未排序区找极值”。
- 快排平均快但会退化;堆保证最坏 $n\log n$ 且原地;归并稳定但数组实现需线性辅助空间。
- 计数排序为 $\Theta(n+k)$,适合值域不大的离散整数键;稳定版本需要前缀和与输出数组。
- 高频陷阱集中在:折半插入的移动量、希尔增量前提、快排递归深度、堆的局部有序、归并空间和稳定性实现条件。